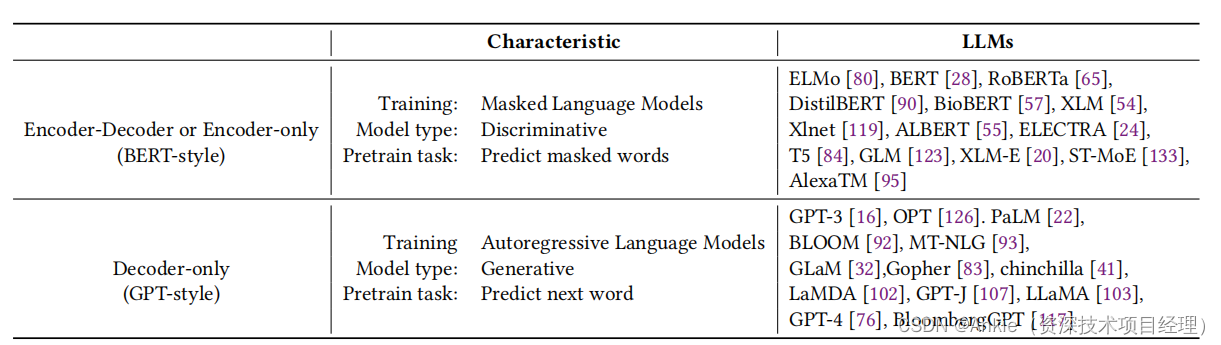
在BERT的论文里面: 2018.10 BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding,BERT已经解释了BERT,GPT,ELMo的区别。

*ELMo为双向RNN,请忽略。
主要区别:
- BERT使用的是transformer的encoder,双向,专注于完形填空。对于缺失的内容和应试内容比较擅长。
- GPT使用的是transformer的decoder,单向,专注于预测,因为decoder看不到后面的字符,训练GPT的预测性能。
- BERT和GPT-1都使用了微调,以应对各种考试。而后期GPT-2,GPT-3抛弃微调,专注于通用人工智能。