如需获取完整源码可私信博主
基于卷积神经网络的人脸面部情感识别及人像卡通化系统设计与实现综述
一、引言
近年来,随着人工智能技术的飞速发展,卷积神经网络(Convolutional Neural Networks, CNN)作为深度学习的核心算法之一,在图像处理和计算机视觉领域取得了显著进展。人脸面部情感识别作为计算机视觉领域的一个重要分支,对于人机交互、情感计算、安全监控等方面具有重要意义。同时,人像卡通化技术也逐渐成为计算机图形学和图像处理领域的研究热点。本文将综述基于卷积神经网络的人脸面部情感识别及人像卡通化系统的设计与实现。
二、卷积神经网络概述
卷积神经网络是一种特殊类型的神经网络,特别适用于处理图像和视频等具有网格状拓扑结构的数据。它通过模拟生物视觉系统的层次结构,能够自动学习和提取图像中的局部特征,并对这些特征进行组合和抽象,以完成复杂的图像识别任务。在人脸面部情感识别中,卷积神经网络通过学习和识别面部图像的细微变化,能够准确地识别出不同的面部表情和情感状态。
三、人脸面部情感识别系统设计与实现
人脸面部情感识别系统主要包括数据预处理、特征提取、情感分类和结果输出等步骤。
数据预处理:对采集到的人脸图像进行预处理,包括人脸检测、对齐、归一化等操作,以提高图像质量和降低识别难度。
特征提取:利用卷积神经网络对预处理后的人脸图像进行特征提取。通过卷积层、池化层等网络结构,自动学习和提取图像中的局部特征和全局特征,为后续的情感分类提供有力支持。
情感分类:将提取到的特征输入到分类器中进行情感分类。常用的分类器包括softmax回归、支持向量机等。在训练过程中,需要使用已标注的人脸情感数据集进行模型训练,以优化分类器的性能。
结果输出:将情感分类的结果以可视化的形式展示给用户,如表情符号、文本描述等。同时,系统还可以提供交互功能,允许用户根据需要对结果进行筛选和查询。
四、人像卡通化系统设计与实现
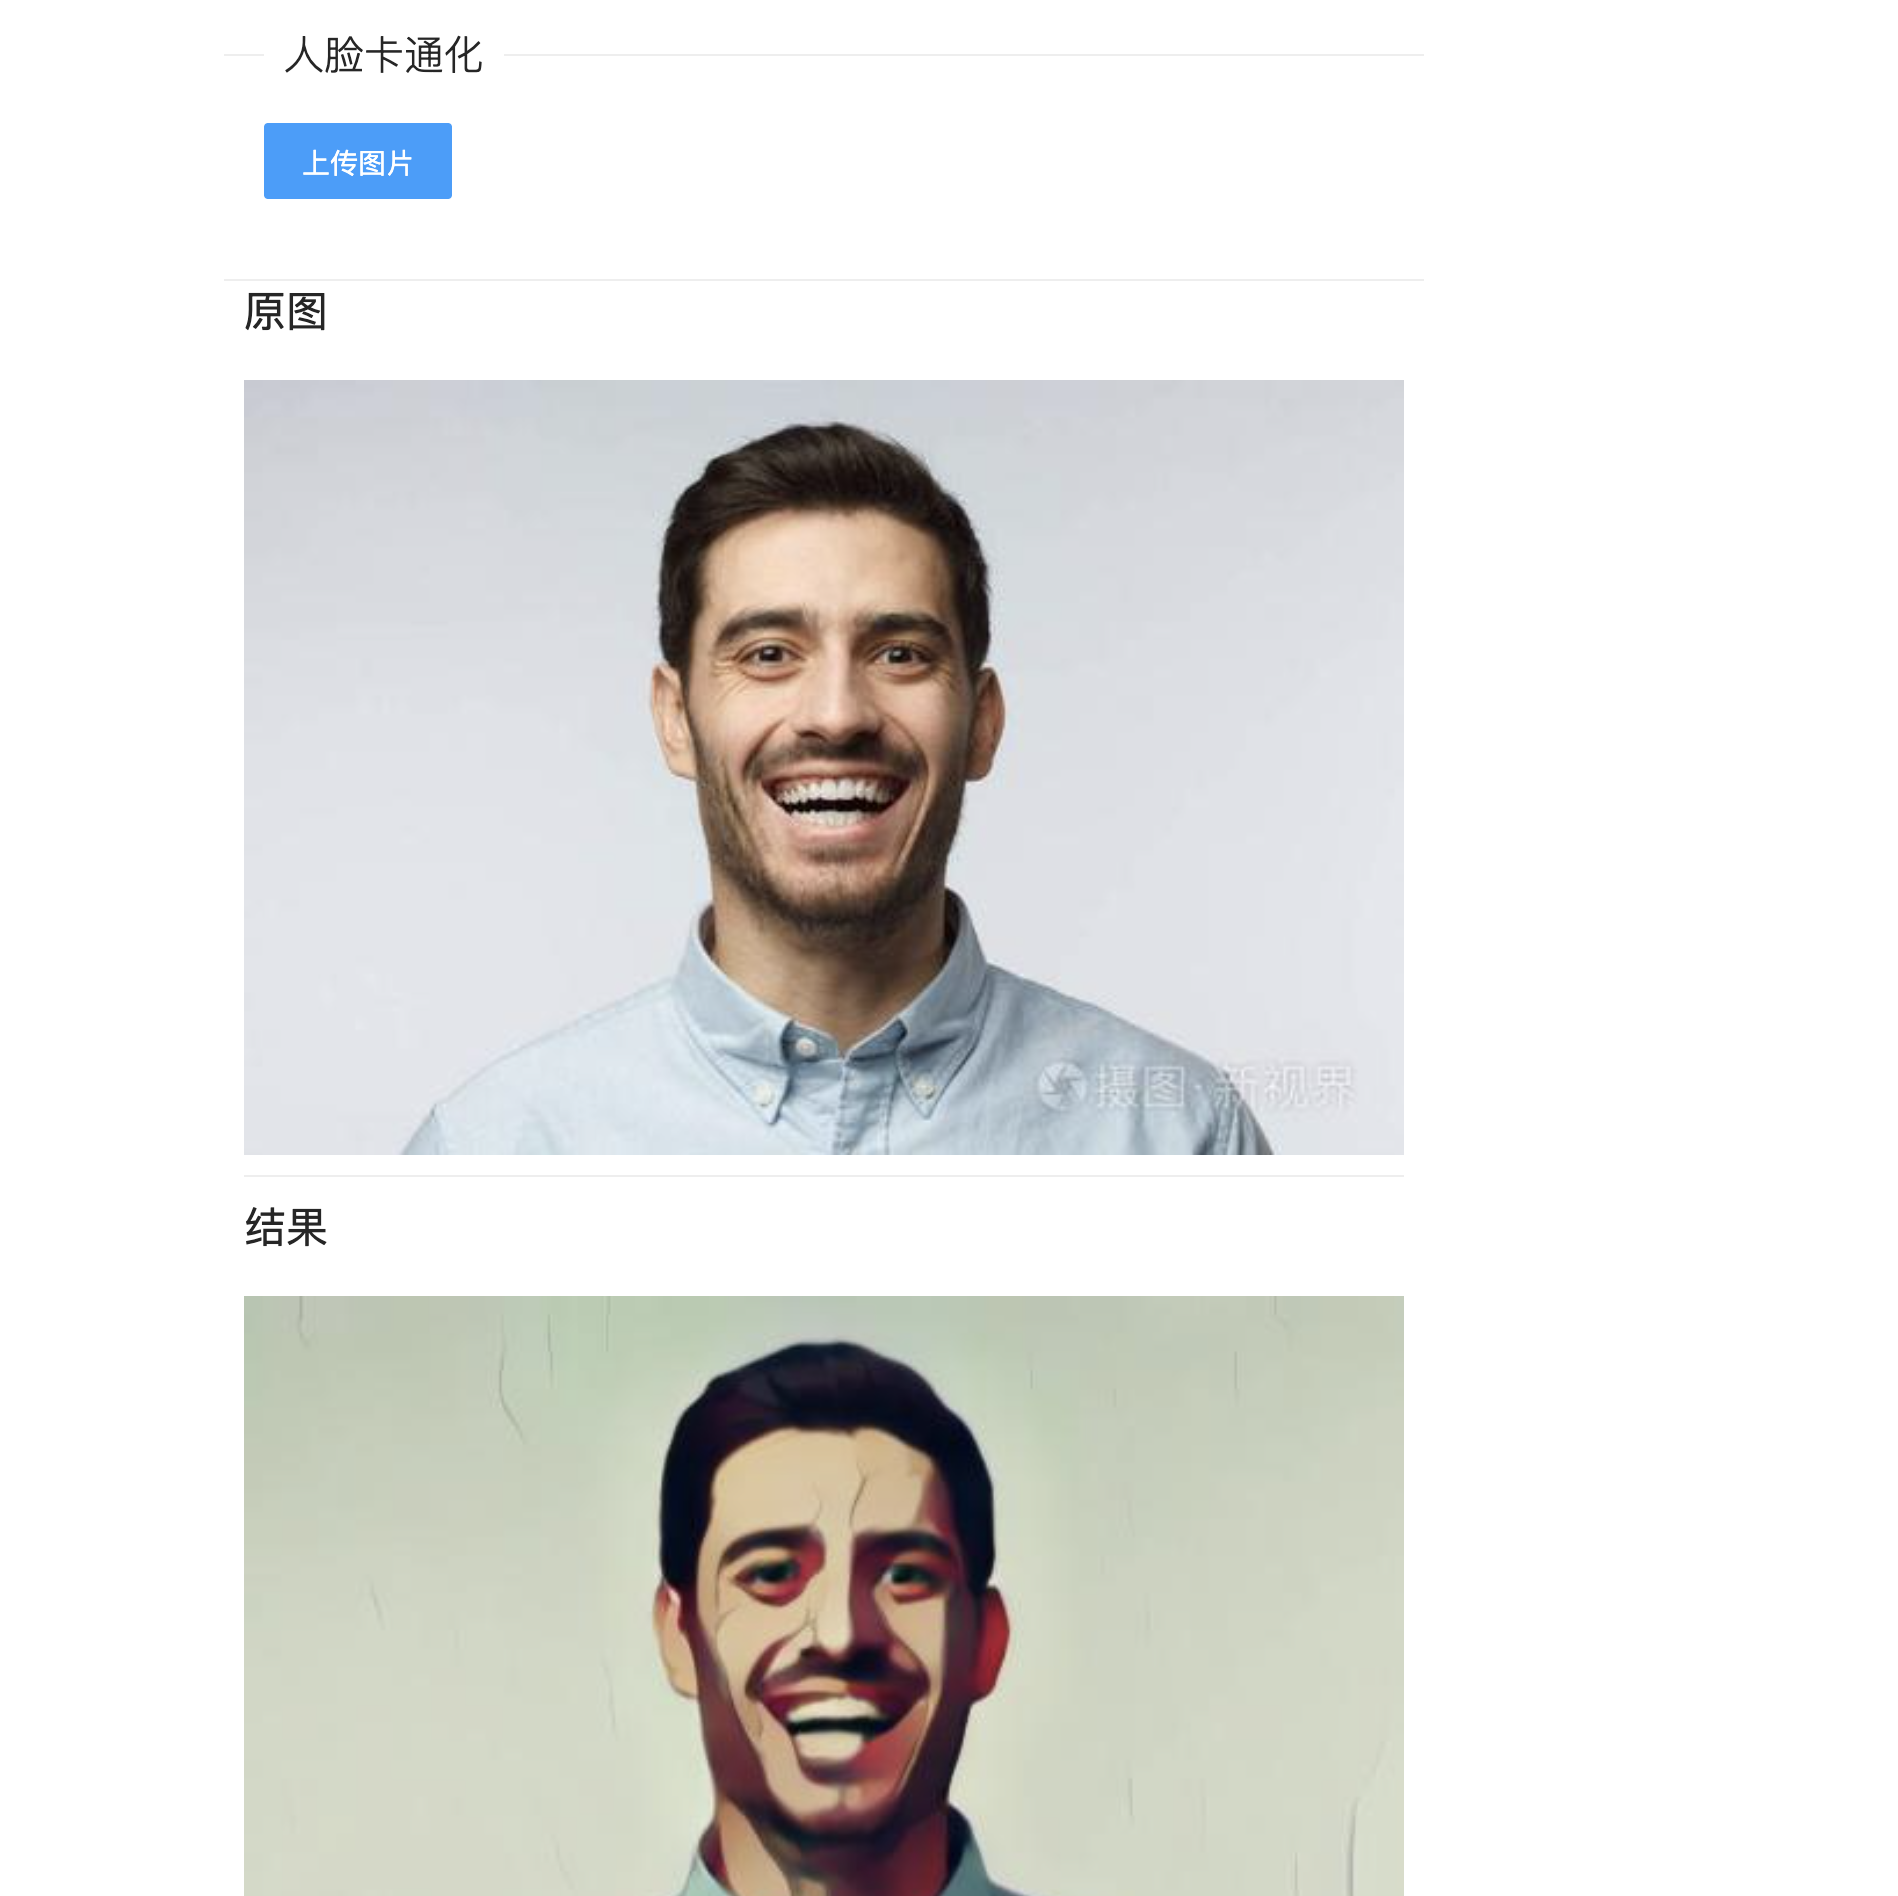
人像卡通化系统主要利用卷积神经网络和生成对抗网络(Generative Adversarial Networks, GAN)等技术,将真实的人脸图像转换为具有卡通风格的图像。该系统主要包括以下几个步骤:
数据收集与预处理:收集大量的真实人脸图像和对应的卡通风格图像作为训练数据。对训练数据进行预处理,包括图像缩放、裁剪、归一化等操作。
网络结构设计:设计合适的卷积神经网络和GAN网络结构。其中,卷积神经网络用于提取人脸图像的特征,而GAN网络则用于生成具有卡通风格的图像。
模型训练与优化:使用训练数据对网络模型进行训练,以优化模型的参数和性能。通过不断调整网络结构和训练策略,使模型能够生成高质量的卡通风格图像。
结果展示与应用:将生成的卡通风格图像以可视化的形式展示给用户。同时,该系统还可以应用于动画制作、游戏设计等领域,为用户提供更多样化的视觉体验。
五、结论与展望
本文综述了基于卷积神经网络的人脸面部情感识别及人像卡通化系统的设计与实现。该系统能够准确地识别出人脸面部的情感状态,并将真实的人脸图像转换为具有卡通风格的图像。未来,随着人工智能技术的不断发展,我们可以进一步探索更加先进的网络结构和算法,以提高系统的性能和泛化能力。同时,我们也可以将该系统应用于更多的领域和场景,如虚拟现实、增强现实等,为用户提供更加智能化和个性化的服务。
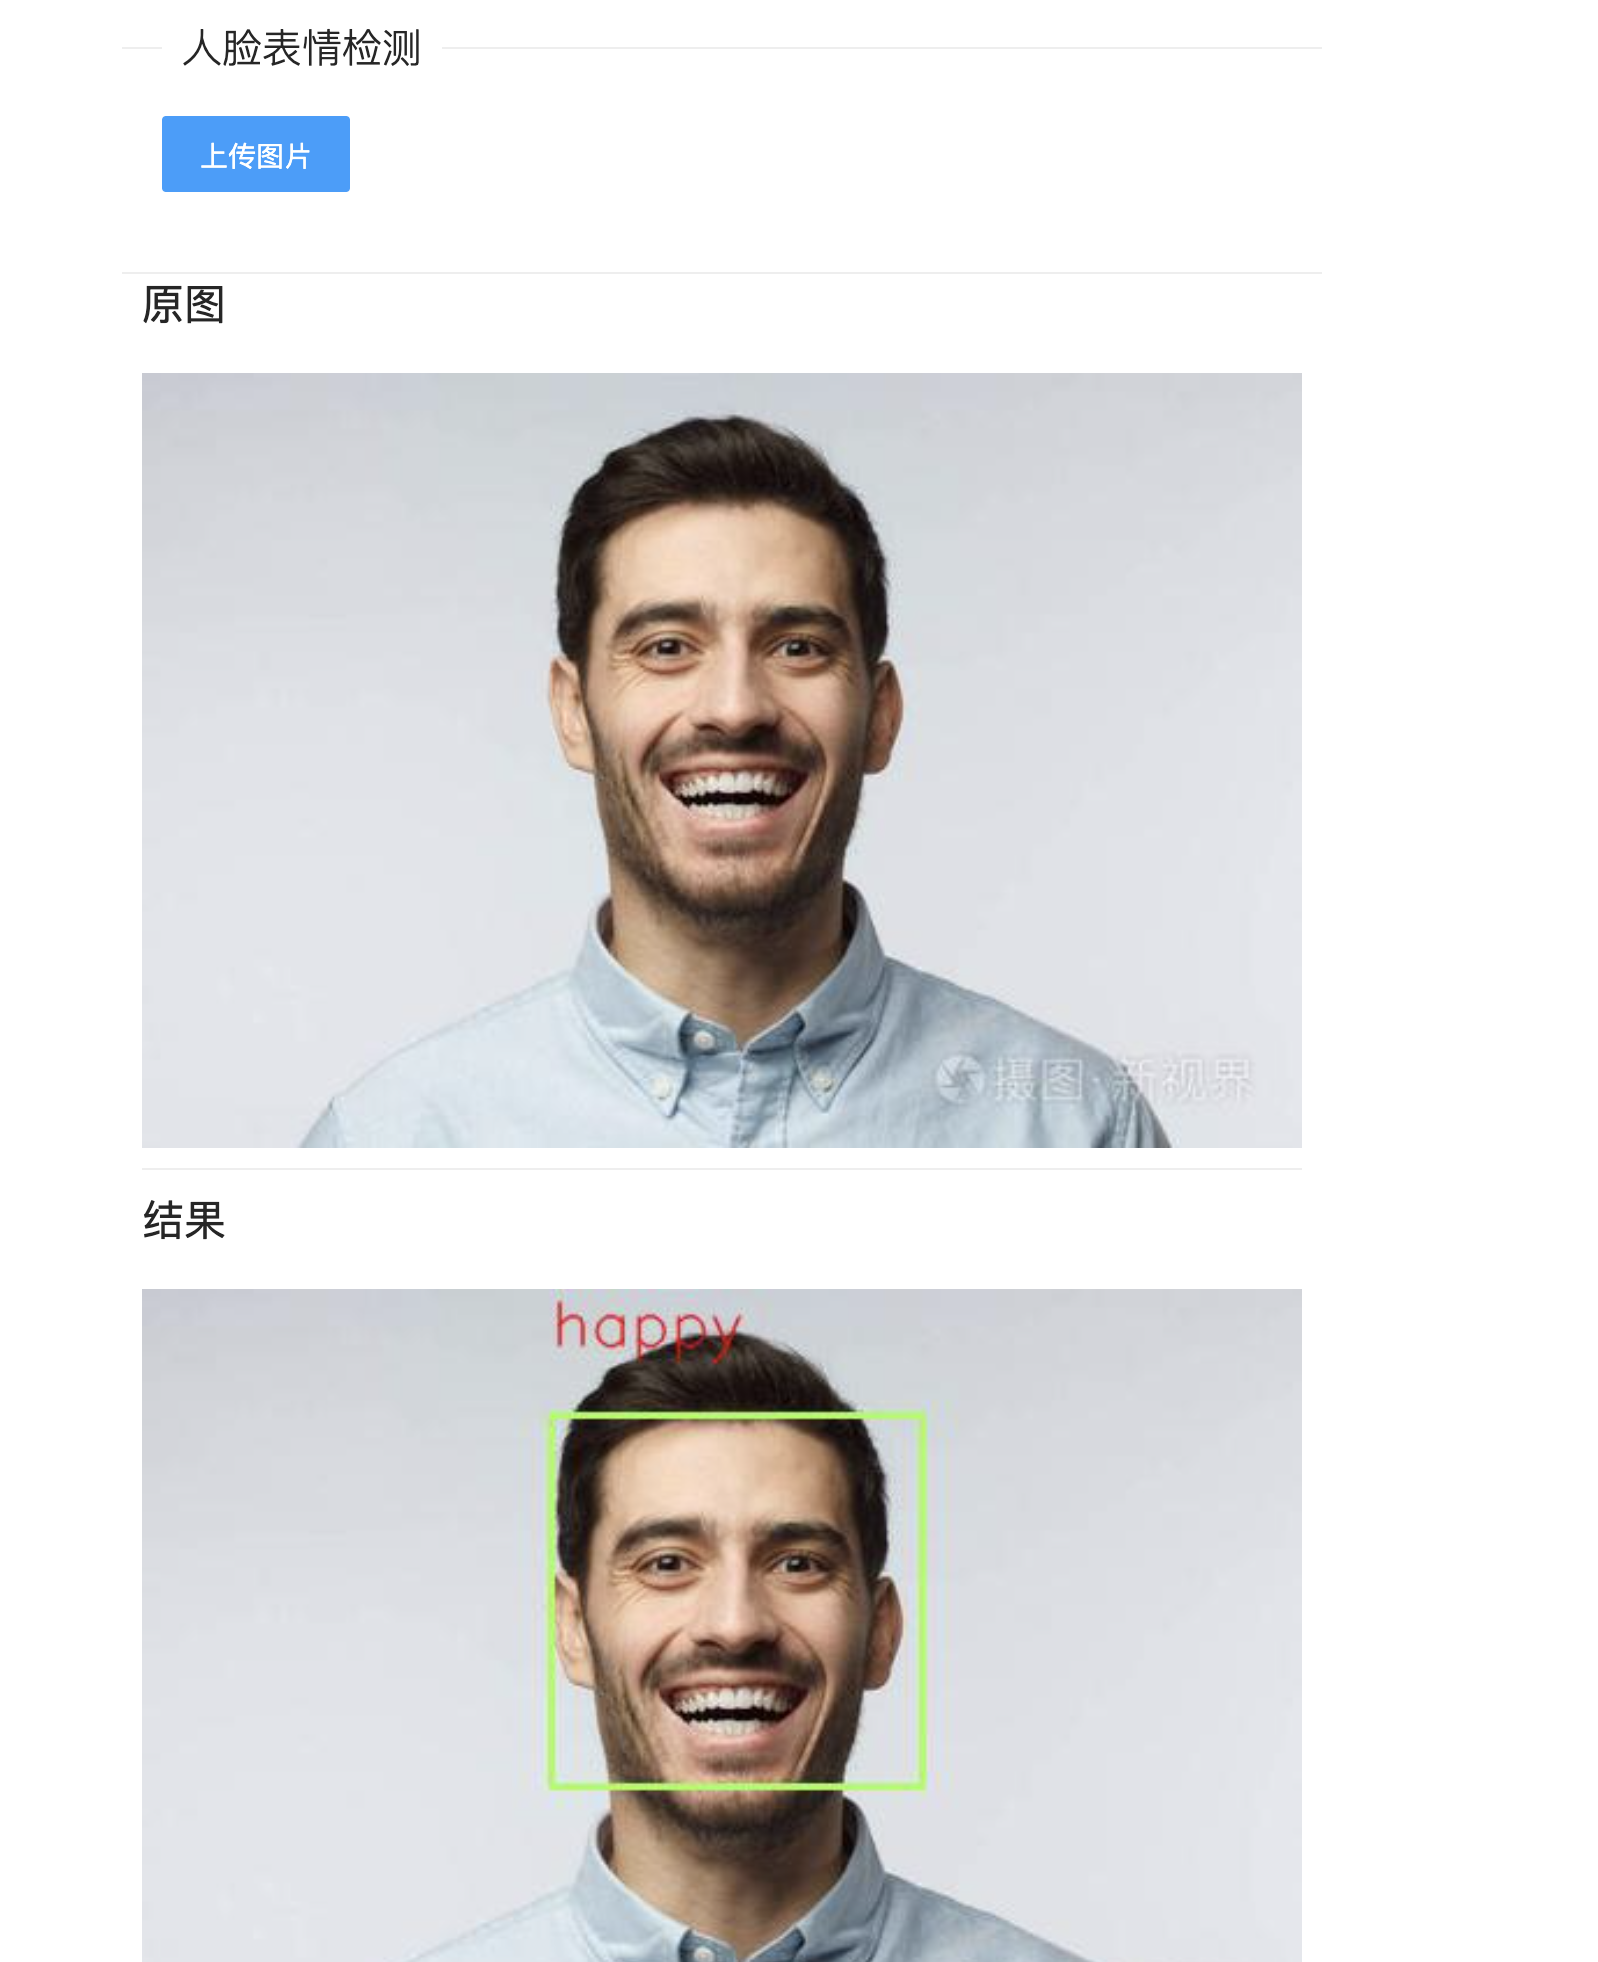
人脸面部情感识别方面,共可识别7中表情,具体如下
{0: ‘angry’, 1: ‘disgust’, 2: ‘fear’, 3: ‘happy’, 4: ‘sad’, 5: ‘surprise’, 6: ‘neutral’}
模型结构代码如下:
class FaceCNN(nn.Module):
    # 初始化网络结构
    def __init__(self):
        super(FaceCNN, self).__init__()

        # 第一次卷积、池化
        self.conv1 = nn.Sequential(
            nn.Conv2d(in_channels=1, out_channels=64, kernel_size=3, stride=1, padding=1),  # 卷积层
            nn.BatchNorm2d(num_features=64),  # 归一化
            nn.RReLU(inplace=True),  # 激活函数
            nn.MaxPool2d(kernel_size=2, stride=2),  # 最大值池化
        )

        # 第二次卷积、池化
        self.conv2 = nn.Sequential(
            nn.Conv2d(in_channels=64, out_channels=128, kernel_size=3, stride=1, padding=1),
            nn.BatchNorm2d(num_features=128),
            nn.RReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),
        )

        # 第三次卷积、池化
        self.conv3 = nn.Sequential(
            nn.Conv2d(in_channels=128, out_channels=256, kernel_size=3, stride=1, padding=1),
            nn.BatchNorm2d(num_features=256),
            nn.RReLU(inplace=True),
            nn.MaxPool2d(kernel_size=2, stride=2),
        )

        # 参数初始化
        self.conv1.apply(gaussian_weights_init)
        self.conv2.apply(gaussian_weights_init)
        self.conv3.apply(gaussian_weights_init)

        # 全连接层
        self.fc = nn.Sequential(
            nn.Dropout(p=0.2),
            nn.Linear(in_features=256 * 6 * 6, out_features=4096),
            nn.RReLU(inplace=True),
            nn.Dropout(p=0.5),
            nn.Linear(in_features=4096, out_features=1024),
            nn.RReLU(inplace=True),
            nn.Linear(in_features=1024, out_features=256),
            nn.RReLU(inplace=True),
            nn.Linear(in_features=256, out_features=7),
        )

    # 前向传播
    def forward(self, x):
        x = self.conv1(x)
        x = self.conv2(x)
        x = self.conv3(x)
        # 数据扁平化
        x = x.view(x.shape[0], -1)
        y = self.fc(x)
        return y
人脸表情检测部分:
detection_model_path = 'model/haarcascade_frontalface_default.xml'
    classification_model_path = 'model/model_cnn.pkl'
    # 加载人脸检测模型
    face_detection = cv2.CascadeClassifier(detection_model_path)
    #加载表情识别模型
    img = Image.open(file_path)
    emotion_classifier = torch.load(classification_model_path)
    opencv_image = cv2.cvtColor(np.array(img), cv2.COLOR_RGB2BGR)
    gray = cv2.cvtColor(opencv_image, cv2.COLOR_BGR2GRAY)
            # 获取当前帧中的全部人脸
    faces = face_detection.detectMultiScale(gray,1.3,5)
    #表情标签
    emotion_labels = {0: 'angry', 1: 'disgust', 2: 'fear', 3: 'happy', 4: 'sad', 5: 'surprise', 6: 'neutral'}

    emotion_window = []
    # 对于所有发现的人脸
    for (x, y, w, h) in faces:
        # 在脸周围画一个矩形框,(255,0,0)是颜色,2是线宽
        cv2.rectangle(opencv_image,(x,y),(x+w,y+h),(84,255,159),2)

        # 获取人脸图像
        face = gray[y:y+h,x:x+w]

        try:
            # shape变为(48,48)
            face = cv2.resize(face,(48,48))
        except:
            continue
        # 扩充维度,shape变为(1,48,48,1)
        #将(1,48,48,1)转换成为(1,1,48,48)
        face = np.expand_dims(face,0)
        face = np.expand_dims(face,0)
        # 人脸数据归一化,将像素值从0-255映射到0-1之间
        face = face/255.0
        new_face = torch.from_numpy(face)
        new_new_face = new_face.float().requires_grad_(False)
        # 调用我们训练好的表情识别模型,预测分类
        emotion_arg = np.argmax(emotion_classifier.forward(new_new_face).detach().numpy())
        emotion = emotion_labels[emotion_arg]
        emotion_window.append(emotion)
        # 获得出现次数最多的分类
        emotion_mode = mode(emotion_window)
        font = cv2.FONT_HERSHEY_SIMPLEX
        # 在矩形框上部,输出分类文字
        cv2.putText(opencv_image,emotion_mode,(x,y-30), font, .9,(0,0,255),1,cv2.LINE_AA)

    rgb_image = cv2.cvtColor(opencv_image, cv2.COLOR_BGR2RGB)


    pil_image = Image.fromarray(rgb_image)
    pil_image.save(save_location)
    # pil_image.show()
    return save_location
人脸卡通画模型部分:
class ConvNormLReLU(nn.Sequential):
    def __init__(self, in_ch, out_ch, kernel_size=3, stride=1, padding=1, pad_mode="reflect", groups=1, bias=False):
        pad_layer = {
            "zero": nn.ZeroPad2d,
            "same": nn.ReplicationPad2d,
            "reflect": nn.ReflectionPad2d,
        }
        if pad_mode not in pad_layer:
            raise NotImplementedError

        super(ConvNormLReLU, self).__init__(
            pad_layer[pad_mode](padding),
            nn.Conv2d(in_ch, out_ch, kernel_size=kernel_size, stride=stride, padding=0, groups=groups, bias=bias),
            nn.GroupNorm(num_groups=1, num_channels=out_ch, affine=True),
            nn.LeakyReLU(0.2, inplace=True)
        )


class InvertedResBlock(nn.Module):
    def __init__(self, in_ch, out_ch, expansion_ratio=2):
        super(InvertedResBlock, self).__init__()

        self.use_res_connect = in_ch == out_ch
        bottleneck = int(round(in_ch * expansion_ratio))
        layers = []
        if expansion_ratio != 1:
            layers.append(ConvNormLReLU(in_ch, bottleneck, kernel_size=1, padding=0))

        # dw
        layers.append(ConvNormLReLU(bottleneck, bottleneck, groups=bottleneck, bias=True))
        # pw
        layers.append(nn.Conv2d(bottleneck, out_ch, kernel_size=1, padding=0, bias=False))
        layers.append(nn.GroupNorm(num_groups=1, num_channels=out_ch, affine=True))

        self.layers = nn.Sequential(*layers)

    def forward(self, input):
        out = self.layers(input)
        if self.use_res_connect:
            out = input + out
        return out


class Generator(nn.Module):
    def __init__(self, ):
        super().__init__()

        self.block_a = nn.Sequential(
            ConvNormLReLU(3, 32, kernel_size=7, padding=3),
            ConvNormLReLU(32, 64, stride=2, padding=(0, 1, 0, 1)),
            ConvNormLReLU(64, 64)
        )

        self.block_b = nn.Sequential(
            ConvNormLReLU(64, 128, stride=2, padding=(0, 1, 0, 1)),
            ConvNormLReLU(128, 128)
        )

        self.block_c = nn.Sequential(
            ConvNormLReLU(128, 128),
            InvertedResBlock(128, 256, 2),
            InvertedResBlock(256, 256, 2),
            InvertedResBlock(256, 256, 2),
            InvertedResBlock(256, 256, 2),
            ConvNormLReLU(256, 128),
        )

        self.block_d = nn.Sequential(
            ConvNormLReLU(128, 128),
            ConvNormLReLU(128, 128)
        )

        self.block_e = nn.Sequential(
            ConvNormLReLU(128, 64),
            ConvNormLReLU(64, 64),
            ConvNormLReLU(64, 32, kernel_size=7, padding=3)
        )

        self.out_layer = nn.Sequential(
            nn.Conv2d(32, 3, kernel_size=1, stride=1, padding=0, bias=False),
            nn.Tanh()
        )

    def forward(self, input, align_corners=True):
        out = self.block_a(input)
        half_size = out.size()[-2:]
        out = self.block_b(out)
        out = self.block_c(out)

        if align_corners:
            out = F.interpolate(out, half_size, mode="bilinear", align_corners=True)
        else:
            out = F.interpolate(out, scale_factor=2, mode="bilinear", align_corners=False)
        out = self.block_d(out)

        if align_corners:
            out = F.interpolate(out, input.size()[-2:], mode="bilinear", align_corners=True)
        else:
            out = F.interpolate(out, scale_factor=2, mode="bilinear", align_corners=False)
        out = self.block_e(out)

        out = self.out_layer(out)
        return out
人像卡通化操作
def Face_Cartoon(image_path: str, type: int, save_location, device='cpu'):
    _ext = os.path.basename(image_path).strip().split('.')[-1]
    if type == 1:
        _checkpoint = './weights/paprika.pt'
    elif type == 2:
        _checkpoint = './weights/face_paint_512_v2.pt'
    else:
        raise Exception('type not support')
    net = Generator()
    net.load_state_dict(torch.load(_checkpoint, map_location="cpu"))
    net.to(device).eval()
    image = load_image(image_path)

    with torch.no_grad():
        image = to_tensor(image).unsqueeze(0) * 2 - 1
        out = net(image.to(device), False).cpu()
        out = out.squeeze(0).clip(-1, 1) * 0.5 + 0.5
        out = to_pil_image(out)
    out.save(save_location)
    return save_location
系统可视化方面,采用Flask框架构建web系统,分别对人脸表情识别及人脸卡通化两项功能进行展示,具体如下: