摘要
除了监督ground truth之外,vanilla KD方法还将教师的预测作为软标签来监督学生模型的训练。基于vanilla KD,已经开发了各种方法来进一步提高学生模型的性能。然而,这些先进的方法很少考虑到教师模型监督的可靠性。来自错误预测的监督可能会误导学生模型的训练。因此,本文建议从两个方面来解决这一问题:标签修订,纠正错误的监督;数据选择,选择合适的样本进行蒸馏,减少错误监督的影响。在前者中,我们建议使用ground truth来纠正教师的错误预测。在后者中,我们引入了一种数据选择技术,选择合适的训练样本由教师监督,从而在一定程度上减少错误预测的影响。
介绍
[8]的开创性工作是使用教师的logits训练学生,这提供了类间概率和相似性的额外知识。具体来说,学生被训练通过最小化KL散度来模仿教师的预测。除了经典的ground-truth标签监督之外,引入了一个额外的logit损失作为强大的正则化,其中教师的预测被视为软标签来监督学生的训练。这种vanilla方法的一个缺点是:教师的知识仅由最后一层表示,而忽视了丰富的中间层信息,这些信息已被证明对学习表示至关重要。最近的工作建立在vanilla KD的理论基础上,旨在通过利用辅助损失函数来克服这一限制,进一步捕获中间特征图中包含的丰富知识。例如,[2]引入了额外的特征匹配和回归损失来优化学生的倒数第二层特征。SemKD[19]使用一种注意力机制来最小化跨层知识蒸馏中的校准损失。也有一些方法侧重于扩展不同的训练策略来提高转移效率。通过这些方法,学生模型的性能不断得到提高。
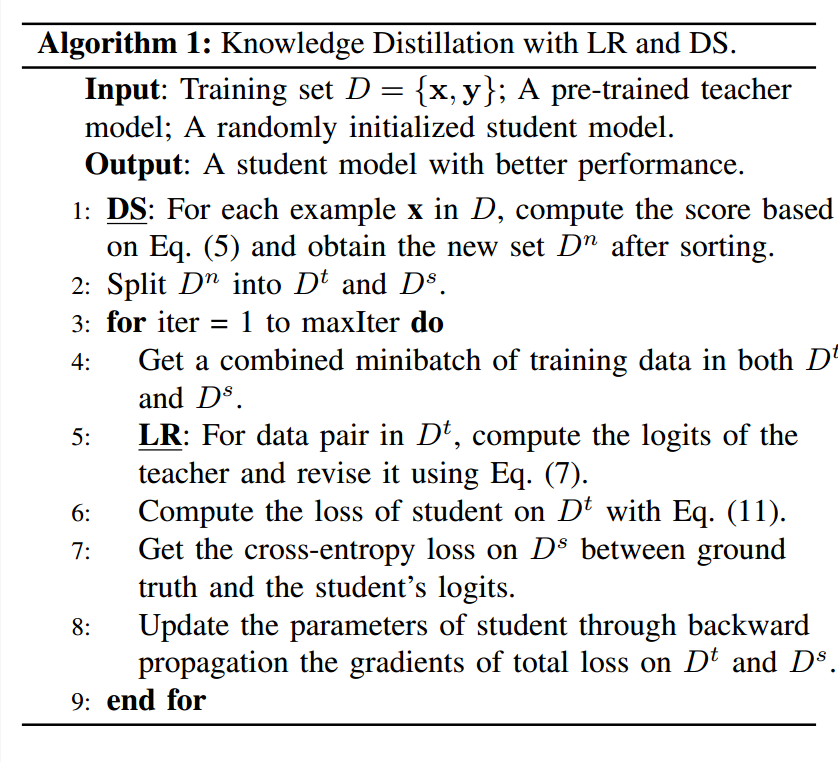
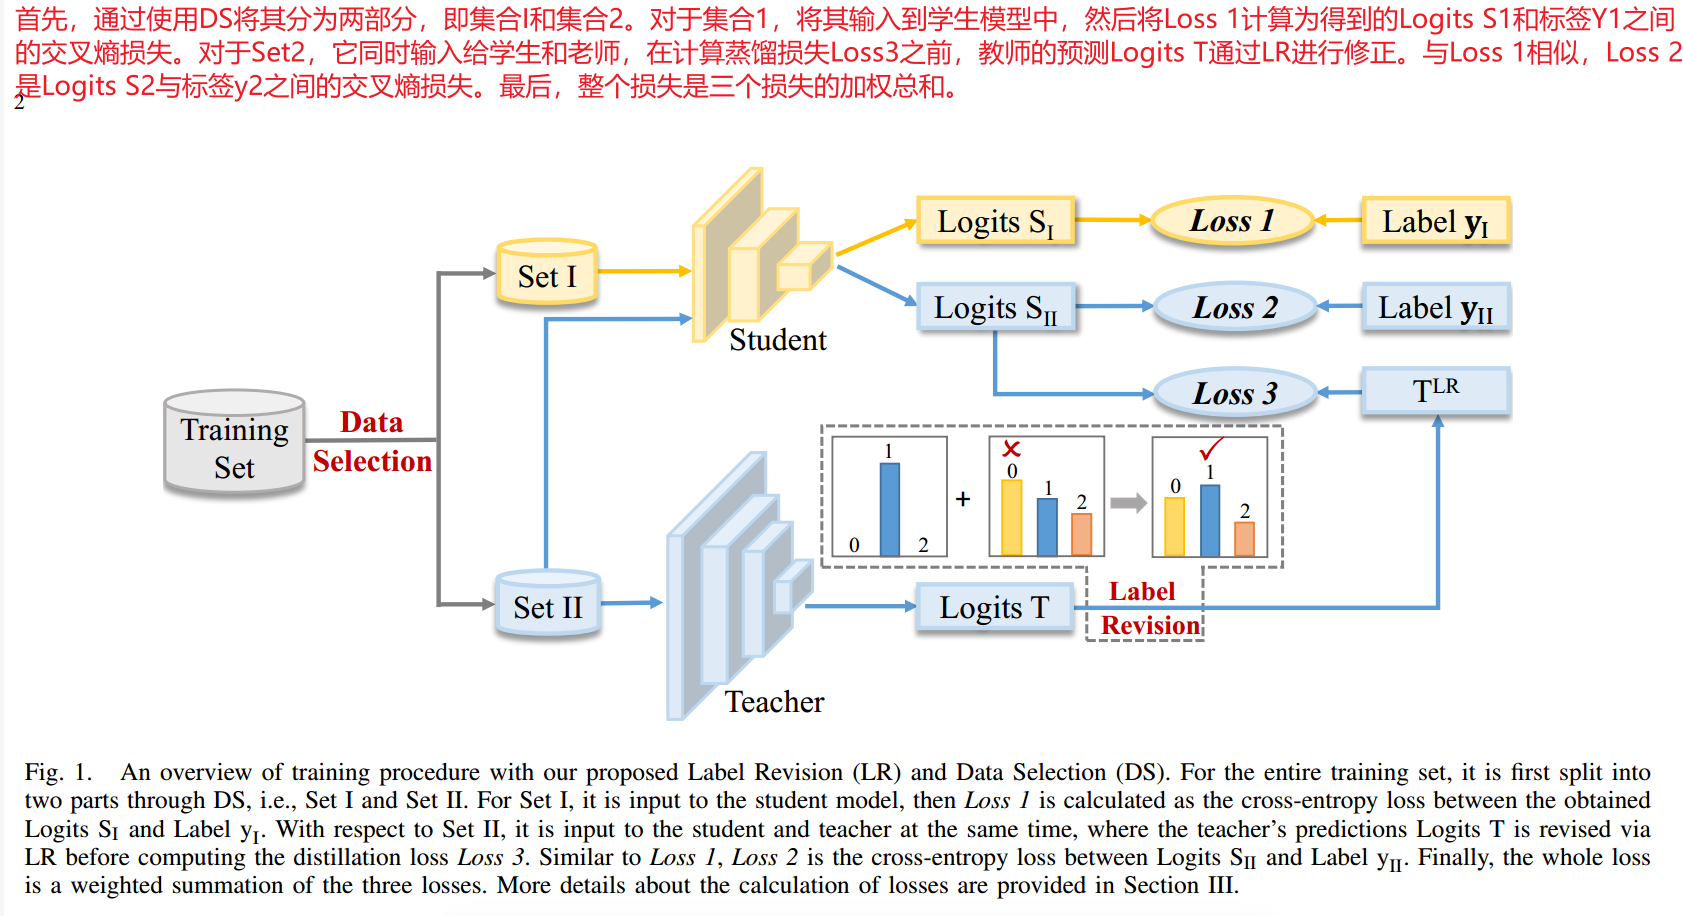
然而,大多数算法是在教师模型的监督下,基于普通的KD框架开发的。虽然教师通常在特定的任务上受过很少的训练,但它仍然包含错误的知识,比如错误的预测。以前的工作没有考虑教师模型的可靠性。因为ground truth标签(硬标签)和教师预测(软标签)都用于监督vanilla KD中的学生,因此在学习过程中会遇到两个问题。第一个问题是:教师也会给出不正确的类分配概率。虽然,这种“暗知识”通常包含有利于泛化的相对概率信息,但它不是完全可信的,一些错误的知识,比如错误的预测,也会传递给学生,误导学习方向。此外,错误的预测会与ground truth相矛盾,可能会造成混乱。类似于显示生活中的课堂学习,如果学生从不同的老师耐得到相同任务的不一致信息,他们将无法做出正确的判断。因此,为了减轻教师的这种不正确监督的负面影响,我们首先提出了标签修订(LR),通过ground truth来纠正教师的错误预测。具体而言,ground truth标签重新制定为热标签,然后根据精心设计的规则将教师软标签与热标签相结合。这样既可以修正教师预测中的错误概率,又可以保持不同类之间的相对信息。
另一个问题是学生是否需要教师对整个数据集进行监督。直观地说,老师提供的指导越多,包含错误预测的可能性就越大。因此,我们进一步引入数据选择(DS)技术,选择合适的数据进行蒸馏,从而在一定程度上减少不正确监督的影响。在整个训练集对学生模型进行训练时,只选择一部分样本由教师使用logit损失进行监督,其余样本使用单一交叉熵损失直接由ground truth进行监督。
贡献
1、为了从教师模型得到更可靠的监督,我们建议使用ground truth来纠正教师软标签中包含的不正确预测。在不破坏隐藏知识的情况下,修正后的标签仍能保持不同类别之间的相对信息。
2、我们引入了一个数据选择技术,选择合适的训练样本从教师蒸馏到学生,进一步减少了错误监督的影响。
相关工作
知识蒸馏
最初,该方法将教师网络的softmax层的输出(称为logits)作为软标签监督学生的训练。在此基础上,后续的工作引入了各种知识表示完成更准确和高效的学习。这些方法可以分为三类:基于Logits、基于特征和基于关系的蒸馏。
基于logits的:在[8]中,logits是指模型的最终预测。vanilla方法通过softmax函数将logits转换为软概率,其中引入温度参数用于缩放包含有价值信息并在监督中起重要作用的小概率。为了提升准确性,许多方法探索了soft标签的潜力,并更好地利用了对数。zhou等分析了soft标签对训练过程中偏方差权衡的影响,提出了将权值动态分配到不同样本中进行平衡。
M等人观察到,当教师和学生之间的差距较大时,学生网络的性能会大大下降。因此,他们引入一个小助手网络来逐步蒸馏知识。K等利用均方误差(MSE)代表了vanilla KD中的KL散度,取得了优异的蒸馏性能。
基于特征的蒸馏:由于基于logits的整流后,教师和学生模型之间的性能差距仍然很大,因此利用特征信息探索了新的知识表示。中间层起着重要作用,当网络较深时,中间层包含的信息也可以作为知识来训练学生。FitNets首先迫使学生模仿教师相应的中间特征。而不是利用特征信息,进一步拟合学生和教师的注意图。此外,[27]通过神经元选择性转移扩展了注意图。为了更容易将知识从教师传递给学生,K等那人引入了几个因素,以更容易理解的格式表示特征。J等人提出了带有路径约束的提示学习,通过教师中提示层的输出来监督学生。VID通过最大化变分信息传递知识。受对比学习的启发,CRD利用教师的表征性知识来捕捉各个维度之间的关系。SemCKD引入了一种注意力机制,可以自动为每个学生层分配教师模型中语义最相关的层,并将这项工作进一步扩展到不同的场景[31]。
基于关系的蒸馏:基于关系的蒸馏方法侧重于不同数据样本或网络层之间的关系。Lee等提出将特征图之间的相关性作为知识,通过奇异值分解提取关键信息。RKD将教师输出之间的结构化关系转移给学生。Passalis等探索了提示信息,利用教师对提示层的相互信息流来训练学生。除了层与层之间的关系外,数据样本中也包含丰富的知识。例如,Passalis等[33]通过数据的特征表示,将数据样本之间的关系建模为概率分布,通过传递概率分布来匹配教师和学生。
相关方法
Preliminaries
Vanilla 知识蒸馏。vanilla KD背后的基本概念是通过最小化他们对给定输入数据集的预测之间的差异来训练学生模型来模仿教师模型的输出。他是通过将原始损失(比如交叉熵损失)和附加的蒸馏损失项相结合完成的。假设教师和学生模型的logits分别为 和
 。则vanilla KD表示为:
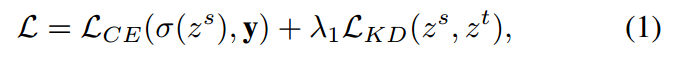
y是ground turth标签。 是softmax函数。
一般来说,蒸馏损失 通常是原始损失函数的soft版本,它鼓励学生学习与教师模型相同的底层信息。在[8]中,将其定义为学生与教师logits之间的KL散度。在原始softmax函数中,输出值被转换为可能类集合上的概率分布。为了让学生掌握更多的知识。蒸馏损失涉及到softmax函数的温度参数
 。因此,蒸馏损失可以重新表述为:
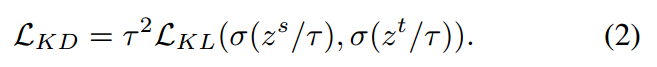
较高的温度T将导致更软和更扩散的概率分布。这种较软的分配鼓励学生从老师的决策过程中学习,而不是简单地模仿它的输出。
数据影响评估。有各种各样的算法来评估不同训练样本的影响。可以帮助选择数据,例如基于影响的方法和基于形状的方法。在这些方法中,影响函数是最流行的数据选择工具之一,因为它具有无需再训练模型的地复杂的的优点。影响函数最早是在统计学领域发展起来的,并被用于测量数据样本的影响。在不重新训练模型的情况下,它提供了一种有效的方法来评估模型预测或参数的变化。
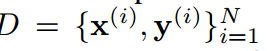 表示给出一组N对数据,模型参数集为,其中收敛后的最优参数为:
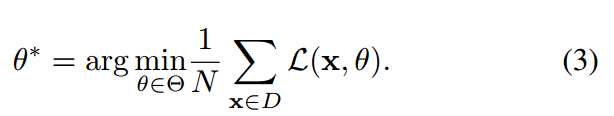
当第i个训练样本 被一个无穷小的阶跃函数
 扰动时,新的最优参数将变为:
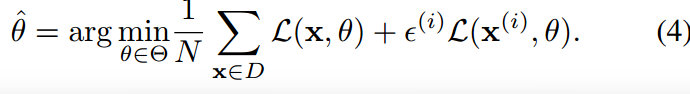
利用影响函数,模型参数的变化可以大致估计为:
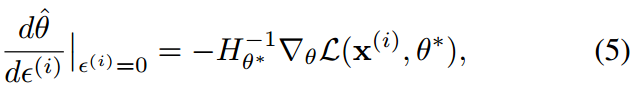
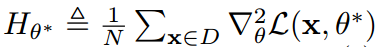 是Hessian矩阵,
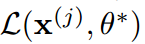 是点
 处的损失。
我们还可以根据链式法则[44]近似处测试样本 处模型预测的变化。
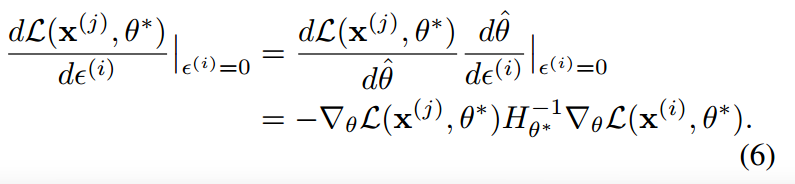
Revise Soft Labels of Teacher修改教师软标签
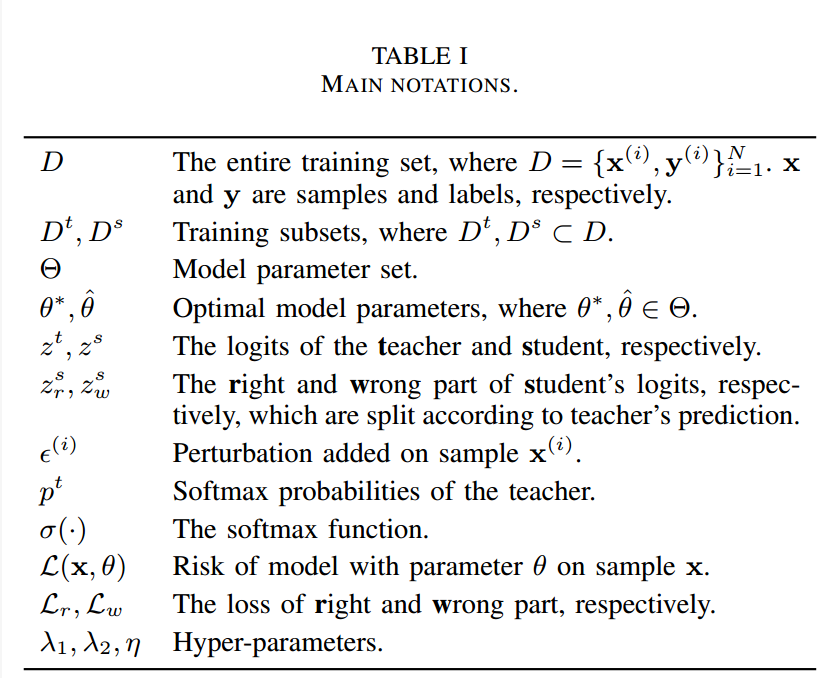
由式(1)中的损失函数可知,学生模型受到教师 和硬标签(即y)的logits监督。然而,即使教师模型得到了很好的训练,它仍然会做出不正确预测,这可能会与硬标签提供的指导相冲突,导致学生模型的准确性下降。vanilla KD方法利用额外的交叉熵损失来减少错误预测的影响,但修正不足以进行可靠的监督,并且仍然存在值得注意的错误信息。为了解决这一问题,我们提出通过修改教师监督的soft标签来提高教师监督的可靠性。具体来说,我们针对教师提供的错误soft标签,提出通过硬标签进行修改,修改后的标签是one-hot形式的硬标签和教师的soft标签的线性组合。假设softmax后教师的最终预测概率为
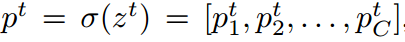 ,其中C为类的个数。则新修订soft标签可计算为:
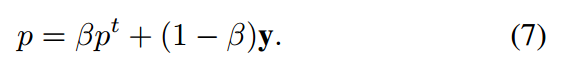
我们将 作为预测类的对应概率,即最大概率,
 作为真实目标类的对应概率。校正概率,使最大概率始终与hard标签一致,权重参数
 的选择需要满足约束条件,即:
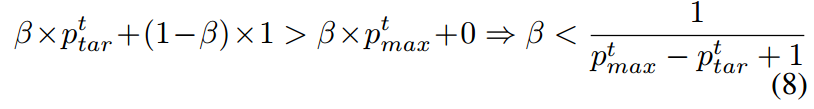
约束可以重新表述为:
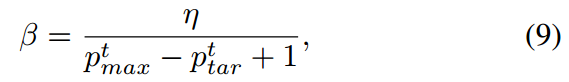
 是小于1的系数。我们提出的策略不像文献[51]那样直接交换目标类和错误类的预测概率,而是从特征表示的角度保持相似类之间的相对概率,这已被证明有利于网络的泛化。
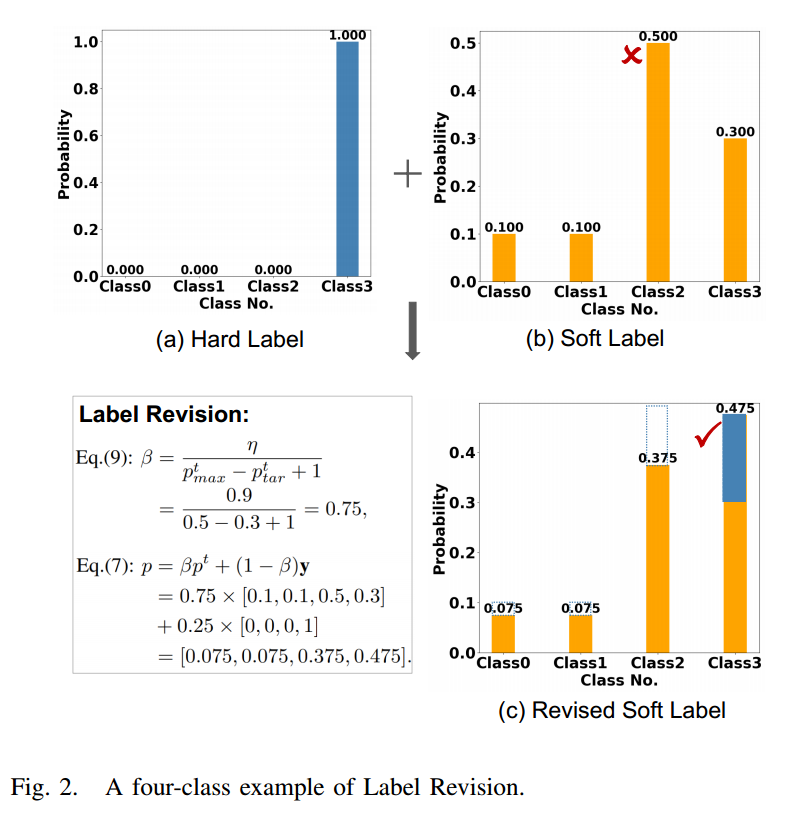
考虑一个四类分类的简单情况,假设有一个属于类别3的样本,one-hot硬标签为y=[0,0,0,1]。然而,教师模型错误地预测为2类,概率为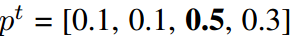 。根据公式(7)提出的策略,当设为0.9时,将软标签修订为p = [0.075,0.075,0.375,0.475]。如图2所示,修改后的目标类获得最大概率。
在获得新的soft标签后,我们可以计算学生和教师之间的损失。为了充分利用logits信息,我们按照文献[12]、[24]的建议,用均方误差(MSE)代替原来的KL损失。因此,错误预测的新损失为:
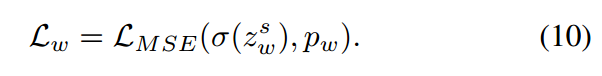
这里不考虑真实和错误预测之间的交叉熵损失,因为 已经包含了来自真实标签的正确信息。学生的logits也使用softmax函数进行规范化以匹配。对于其余不需要修正的正确部分,损失
 由式(1)计算。
通过整合错误部分和正确部分,我们可以得到总的损失为:
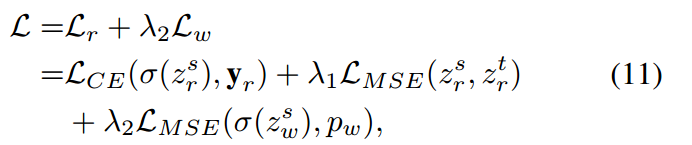
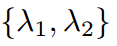 为各项平衡系数,可灵活调整。修正后的错误部分soft标签由等式(7)计算。
选择合适的数据进行蒸馏
以前的KD方法大多侧重于从老师身上提取更多的信息,以提高学生的准确率,但很少考虑训练数据的影响,而训练数据对监督学习的性能有显著影响。为了减轻教师的错误监督,我们建议修改上一节的soft标签。从训练数据的不同角度来看,是否有必要将教师的监督应用到整个训练集上也是值得考虑的。因此,我们引入了一种数据选择技术来进一步降低错误监督的风险。
为了训练一个学生模型,我们只选择一部分训练样本来从教师那里转移知识,其余的样本由ground truth直接监督。具体来说,对于预训练的教师模型,我们首先使用等式(5)计算训练集D中每个样本的影响分数。并根据这些分数对样本进行排序,形成新的集合 。然后,我们将
 划分为两个子集
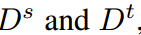 ,
 由带有修改soft标签的教师监督,而
 仅由ground truth监督。子集
 上的损失由等式(11)计算,而上
 的损失是学生预测与ground truth之间的原始交叉熵损失计算。最后,总损失是这两个损失的总和。值得注意的是,
 的分割是灵活的,例如我们可以选择样本的前50%(或20%、80%等)作为
 ,剩下的作为
 。
公式如下: