文章目录
一、进程概念产生的原因
引入进程其实是为了满足“并发编程”的需求(此处的并发=并行+并发)。随着时代发展,技术越来越成熟,cpu 逐渐变成多个核心,此时应用程序(软件)也需要做出对应的调整,让代码能够支持多核心cpu,即在代码中可以把多核心充分利用起来。(硬件发展,软件也要跟上)
二、进程的弊端
多进程已经很好的实现了 “并发编程” 的效果,但是还是具有明显的缺点:进程比较厚重。具体表现在:
1、消耗过多系统资源
2、速度更慢
进程运行需要消耗资源,如果是在频繁的创建以及销毁(申请/释放资源)的情况下(服务器里会这样频繁操作),开销就会很大,系统压力也会很大,运行效率也会降低。
此时为了能够保留进程 “并发编程” 的效果,并且还能提升其 创建/销毁 的速度,就引入了 线程。
三、线程
最初是尝试在创建进程时,只给进程分配一个简单的PCB,而不去分配后续进程运行时所需的系统资源,此时这类进程称作——轻量级进程(也叫做 线程 Thread),但是这样的尝试还是出现一个问题:线程创建出来,也是为了到cpu上执行,完成相关任务的。执行时就需要依靠系统分配给的资源进行运行,但是此时只简单分配了一个PCB,没给资源,这样创建出来的线程也没办法进行 “并发编程”,违背了初衷,这个尝试以失败告终。
此时第二次尝试:还是创建进程,但创建进程的时候,将进程运行时用到的系统资源分配好,后续再在进程内部创建线程,此时创建出来的进程内部的线程,直接复用了进程里面已经分配好的资源。
刚创建出来的进程,可以视为是一个只包含一个线程的进程(此时创建的过程需要分配资源,因此此时第一个线程创建的开销就可能比较大,后面再在这个进程里创建的线程,直接复用当前进程的资源,开销就比较小)
一个进程,至少包含一个线程,也可以包含多个线程。这些线程各自独立的在 cpu 上进行调度,因此线程既能够完成 “并发编程” 的效果,又可以以比进程更轻量的方式运行。
举个例子,加深一下对线程的理解:


3.1、线程复用结构体PCB
前面我们知道了系统使用结构体PCB描述进程,PCB又叫做进程控制块。那使用什么结构体描述线程呢??还是使用PCB描述线程。
在 Windows 操作系统中,描述进程和线程是使用不同的结构体,但是在 Linux 操作系统中,复用了PCB这个结构体,来描述线程。此时,一个PCB 对应 一个线程,多个 PCB 对应一个 进程。
由于同一个进程中的多个线程共用进程里的同一份资源(内存资源、硬盘资源),因此同一个进程中的多个PCB里的内存指针、文件描述符表,这两个字段的内容都是一样的。
但是每个线程独立到cpu上调度,因此这些PCB里的状态、优先级、上下文、记账信息…都是各不相同,各有一份的。
因此此时我们知道:
1、进程是系统分配资源的基本单位。
2、线程式系统进行调度执行的基本单位。
3.2、多线程弊端
虽然线程比进程更轻量,但也并不是一点资源都不消耗。并且也不是一个进程中创建的线程越多越好(多线程)。
举个例子说明原因:
3.2.1、拖慢程序的效率

对于线程来说也是一样的,线程太多的时候,其调度的开销反而会拖慢整个程序的效率。
3.2.2、产生线程安全问题

对于线程来说也是一样的,线程太多的时候,就极有可能出现bug,即线程安全问题(多线程编码中,最关键的问题)。
3.2.3、导致整个进程终止

对于线程来说也是一样的,一旦某个线程执行过程中出现异常,并且这个异常不能很好的被解决掉的话,有可能殃及其他线程,甚至很有可能导致整个进程终止(进程中的所有线程也随之终止)。
所以多线程虽然比多进程相比,确实是有优势的(因为线程更轻量,创建销毁的速度更快),但是线程也有缺点(不像进程那么稳定,一旦某个线程出现问题,很容易殃及其他线程)。
多线程、多进程 本质上都是 “并发编程” 的实现模型,实际上还有许多其他的 “并发编程” 的实现模型。
3.3、怎么判断一个线程是否执行完毕??
对于主线程来说,main() 方法是其入口方法,如果 main() 方法里的代码逻辑执行完毕,那么主线程也就执行完毕了。对于其他我们创建出来的线程,run() 方法或者Lambda表达式里的代码逻辑执行完毕,那么这些线程也就执行完毕了。
3.4、怎么提前终止一个线程??
一个线程的 run() 方法执行完毕,就算终止(正常结束)了。
此处的终止线程,是借助别的手段,让 run() 方法能够尽快的执行完毕,因为正常情况下,是不会出现 run() 方法还没执行完毕,线程就突然没了的情况,除非是机器自动关机或者拔电源…但是还有一些人工干预的办法,譬如说如下方法:
3.4.1、程序员手动设置标志位。
public class testInterrupted {
//    设置标志位
    public static boolean isQuit = false;
    public static void main(String[] args) throws InterruptedException {
        Thread t = new Thread(()->{
            while (!isQuit){
                System.out.println("hello world!");
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
        });

        t.start();

        Thread.sleep(2000);
//        修改标志位
        isQuit = true;
    }
}
运行结果:

将死循环的线程提前终止了。
3.4.1.1、变量捕获
上述代码中我们是把标志位 isQuit 设置成成员变量,此时变量时能够被访问到的,那么如果我们把 isQuit 设置成了 main() 函数里的局部变量,那么此时我们的代码会发生什么变化??
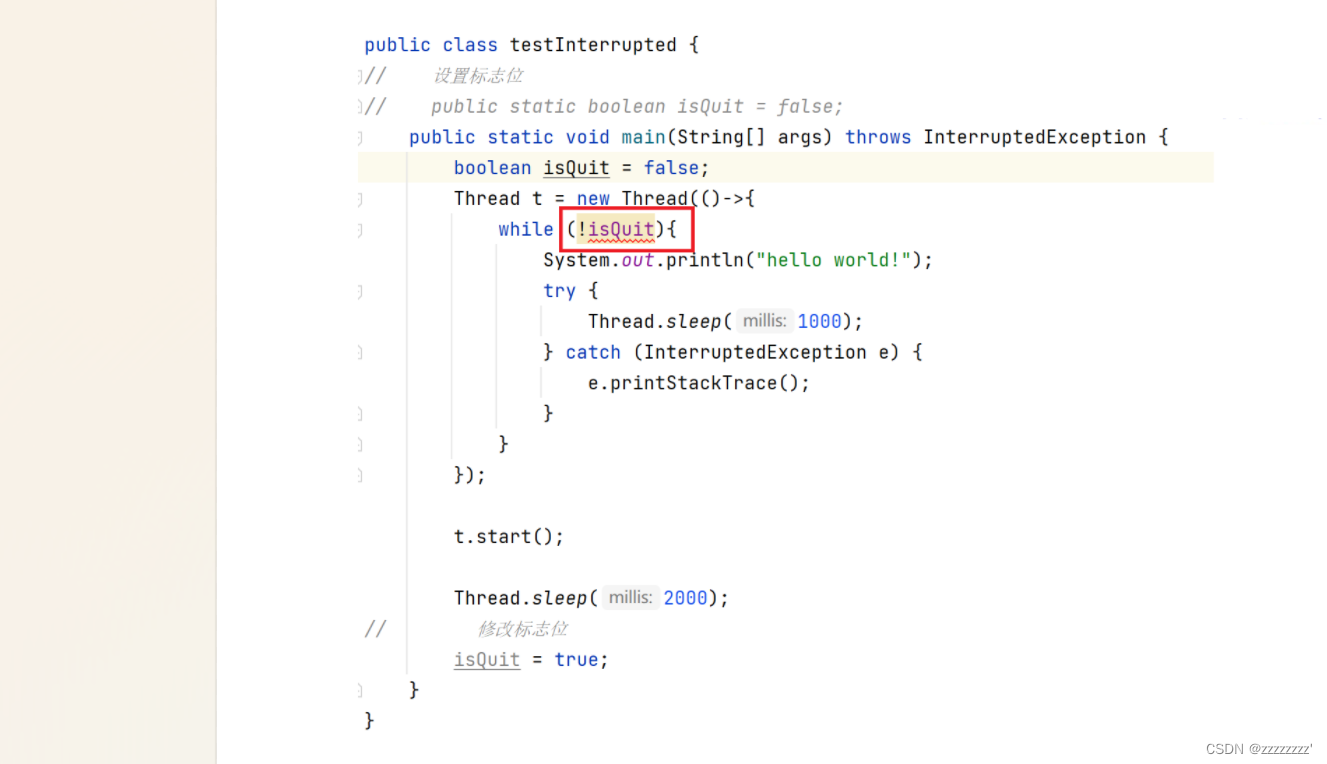
我们会发现,代码爆红了!代表此时该变量无法被访问到了,这是为啥呢??
Lambda 表达式的执行时机并非是立即执行,它相当于是一个回调函数,它的执行时机是当线程被创建好了之后,在另外一个线程内部执行, 因此它的执行时机是比较靠后的。
那么此时由于Lambda表达式的这个特性,就导致了后续真正执行Lambda表达式的时候,局部变量 isQuit 就有可能已经被销毁了(main() 方法执行完完毕了,另一线程还在执行),此时再想访问局部变量 isQuit 就没办法访问到了,因此代码爆红了。
所以 Lambda为了解决上述问题,就引入了 “变量捕获” 这样的机制——Lambda可以捕获到外面的变量。
Lambda 看起来是在直接访问外部的变量,其实本质上是把外部的变量复制了一份到 Lambda 里面,此时Lambda访问的变量已不再是原来的变量了,而是复制过后的变量,这样就可以解决上述生命周期的问题。
但是变量捕获的使用是有一定规则的:要求被捕获的变量得是 final 修饰的(至少事实上是final),即要求此变量是不可变的。如果变量没使用final修饰,但是如果在代码中没有对此变量进行二次修改,那么此时也是不会报错的。
如果这个变量想要修改,就不能进行变量捕获了。
3.4.2、使用 Thread 类自带的标志位
/**
 * 使用 Thread 类提供的现成标志位
 */
public class testInterrupted2 {
    public static void main(String[] args) throws InterruptedException {
        Thread t = new Thread(()->{
//            isInterrupted() 是否设置了标志位
            while (!Thread.currentThread().isInterrupted()){
                System.out.println("hello world!");
                try {
                    Thread.sleep(2000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
        });
        t.start();
        Thread.sleep(3000);
//        设置标志位
        t.interrupt();
    }
}
运行结果:
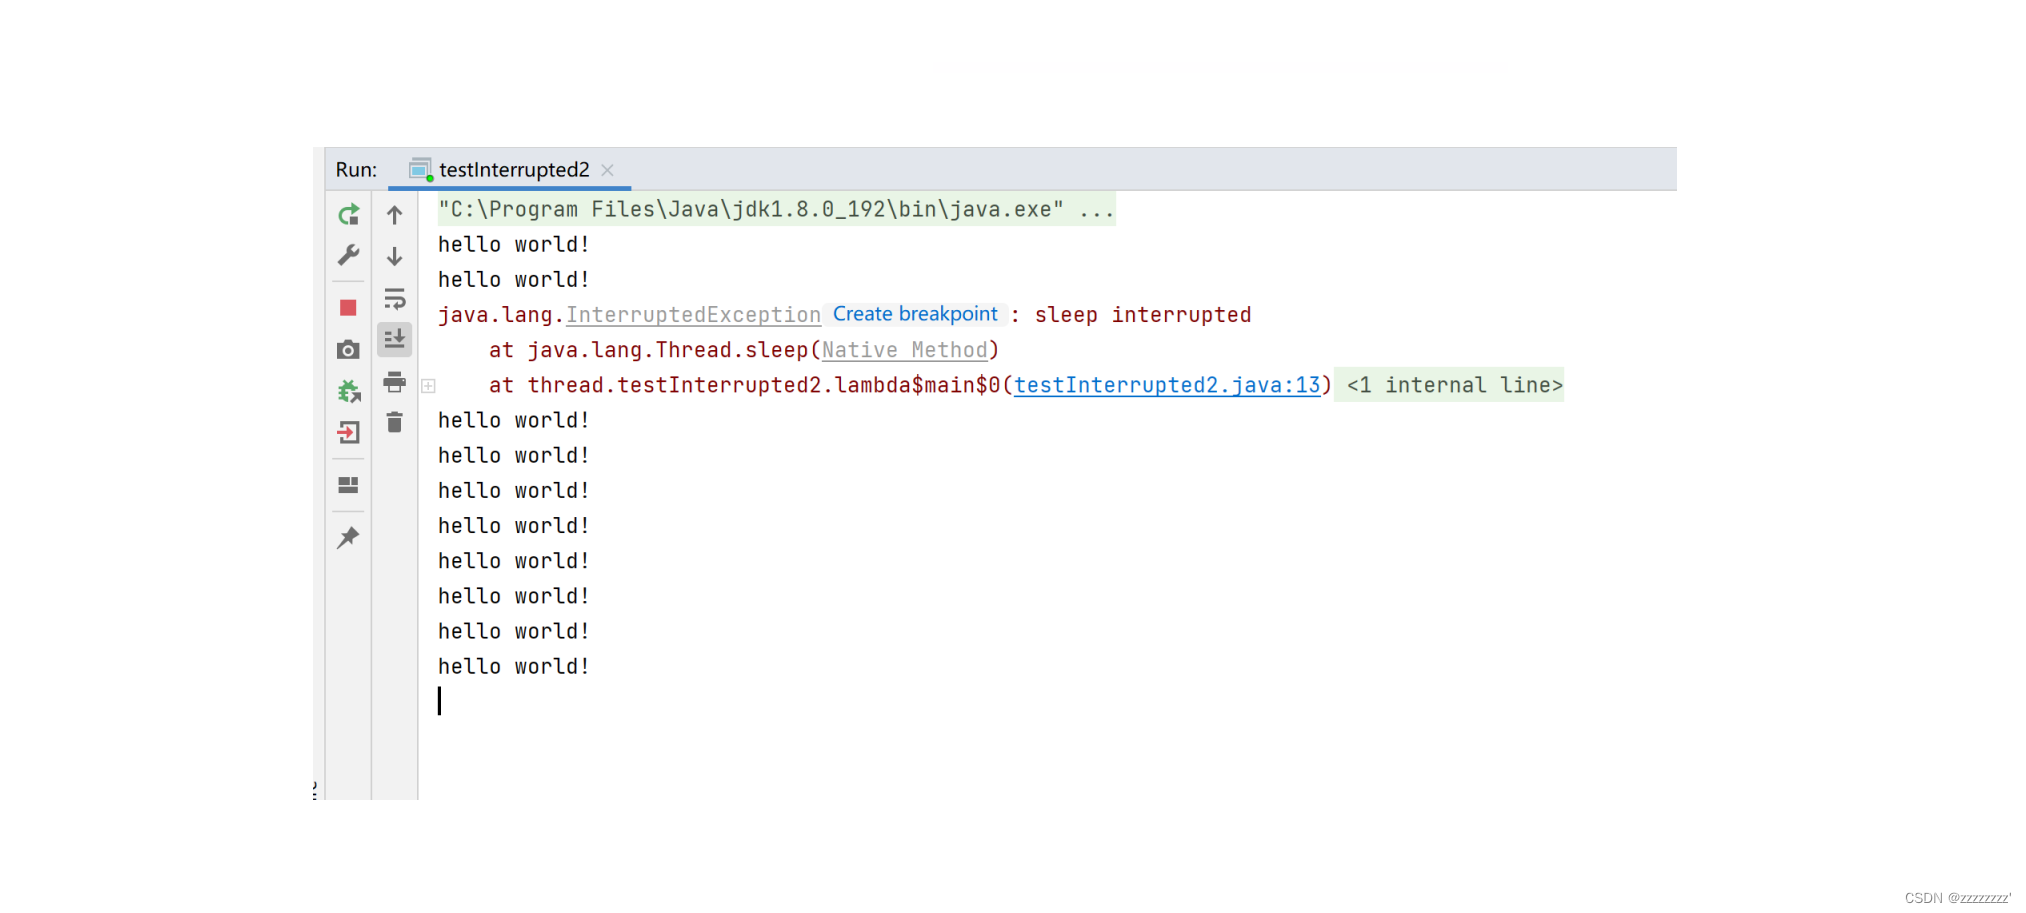
我们可以看到这个运行结果有点奇怪:为什么出现了一个异常信息的打印之后,代码还能继续再运行着?
其实我们这个通过 Thread 类自动设置标志位时,我们新创建的线程在执行sleep() 方法时,其他线程在执行 interrupt()方法,interrupt() 方法会使这个 sleep() 方法被提前唤醒,并且此时设置的标志位会被清除,按照我们上述的代码逻辑,此时就会导致抛出异常。如果是手动设置的标志位,是没办法提前唤醒sleep()方法的。
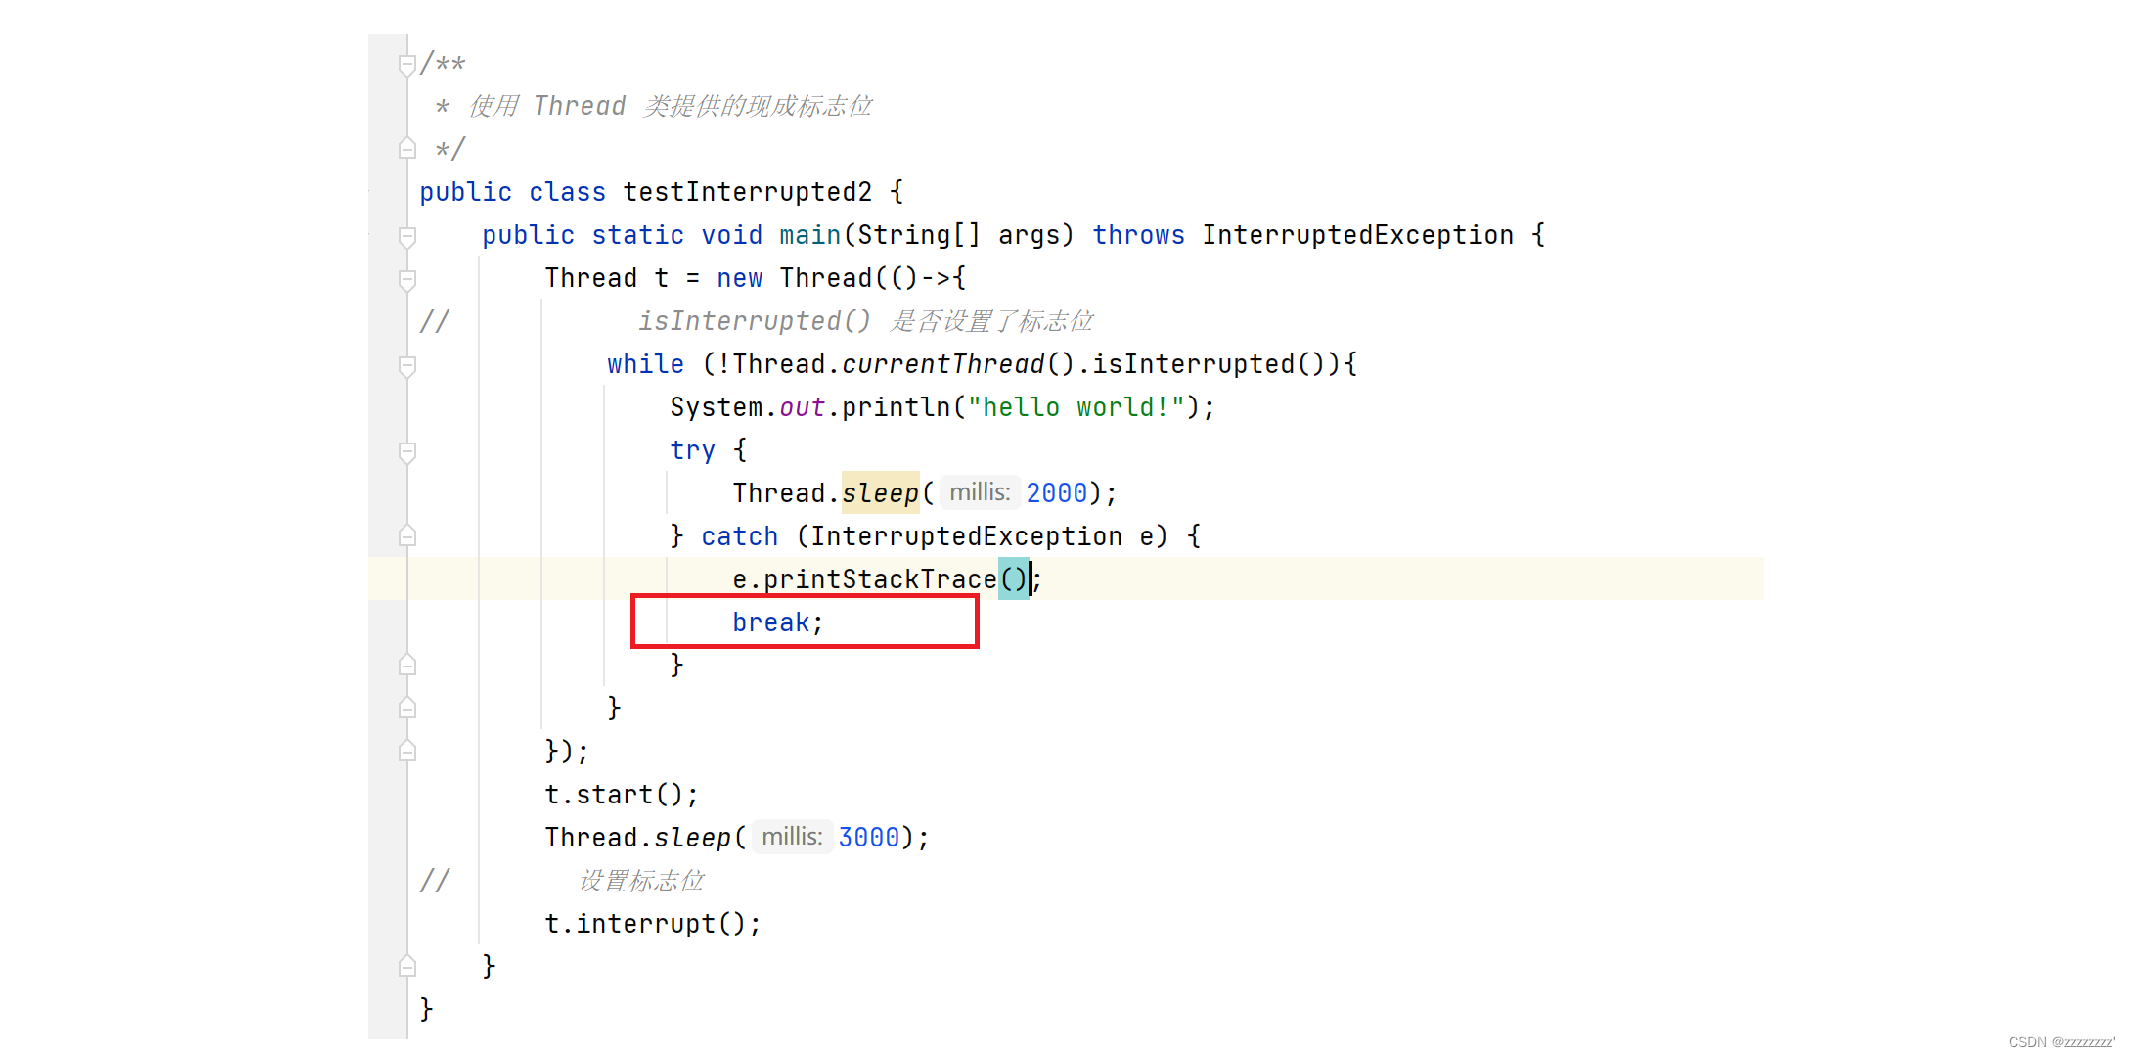
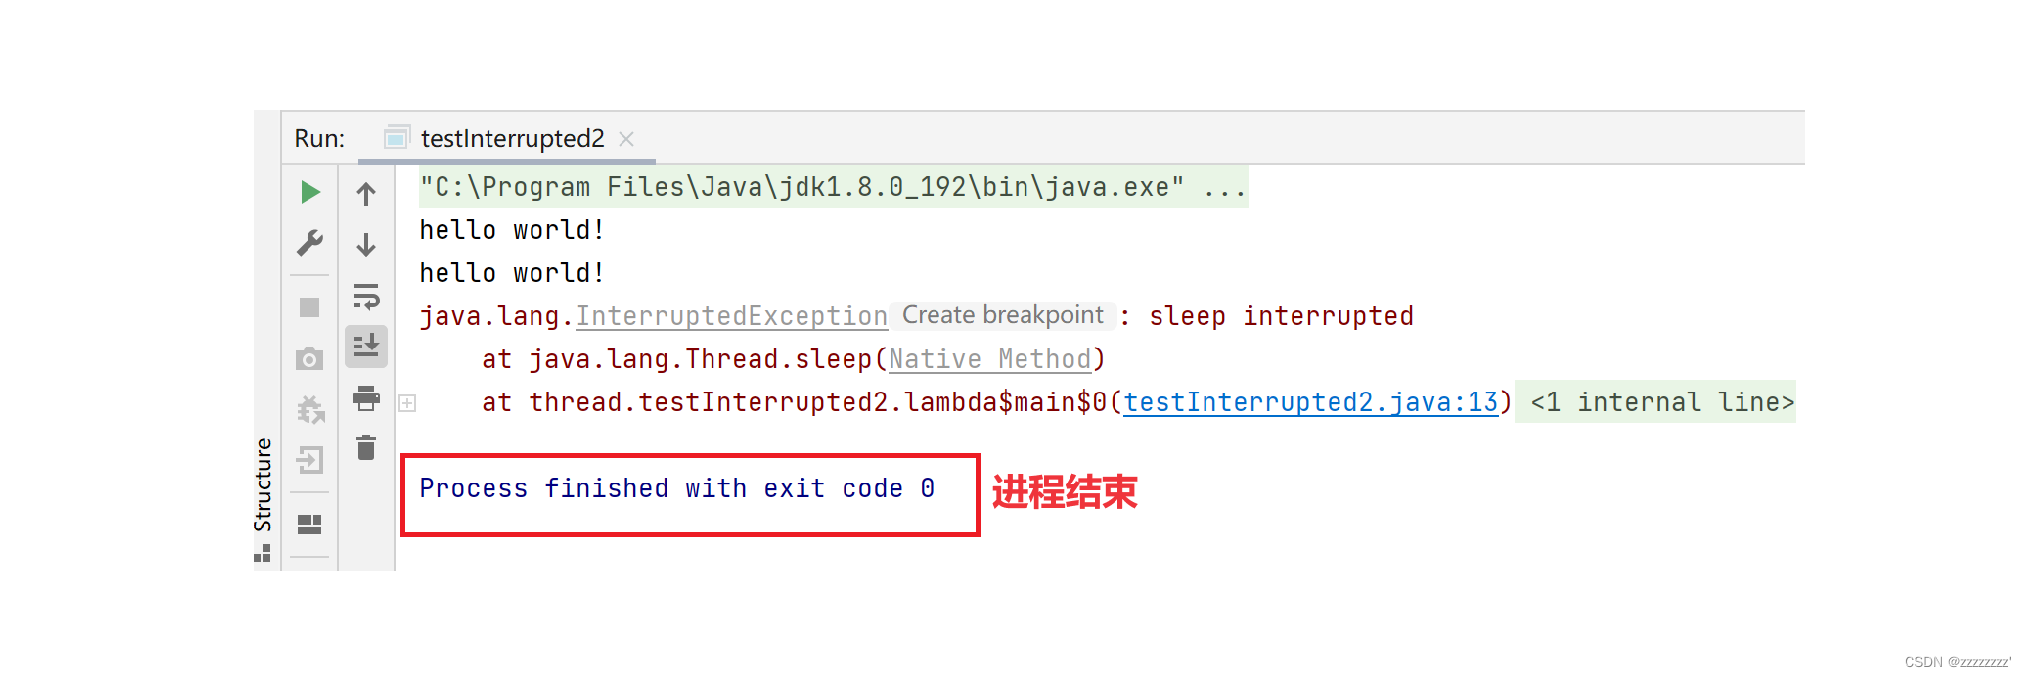
如果我们希望sleep()被提前唤醒以至于抛出了异常之后线程不再继续执行了,可以在catch内添加代码:break; 此时就会进程就会结束。
四、进程与线程的区别及联系[高频面试题]
1、进程包含线程。都是为了实现 “并发编程”,但线程比进程更轻量。
2、进程是系统分配资源的基本的单位,线程是系统进行调度执行的基本单位。
3、进程具有独立的地址空间,彼此之间不会相互影响,线程共用一份地址空间,容易相互影响导致整个进程由于异常结束。
五、线程的弊端
注意:上面提到的是 多线程的弊端,这里提到的是线程本身的弊端,这是两个概念,注意区分。
线程相较于进程来说的确是比较轻量的,但是也不是没有创建/销毁的成本。当遇上高并发服务器时,由于要处理的并发量太多了,需要频繁的 创建/销毁 线程,开销仍然不可忽视。
六、解决线程弊端的方法
那么有什么比线程更轻量或者开销更小的方法吗?
6.1 协程/纤程
1、为了解决这样的情况,有些程序员提出了 “轻量级线程” —— 协程/纤程 这样的概念。 但是由于只有一些第三方库实现了协程,Java标准库目前还没有内置关于协程的使用类,所以在Java中还没有开始大量使用协程这样的概念。
但是 Go语言 里天然支持协程,协程使用起来非常高效、方便。所以大家如果对协程有兴趣,可以深入学习一下 Go 语言。
6.2、线程池
池(pool)其实是计算机中非常经典的一个思想方法。
在程序中,我们通常会把一些要释放掉的资源先存放到一个 “池子里” ,预防后续可能会再次用到这些资源,但却无法找到的风险。
申请资源时,也是把要申请的资源提前申请好,存到一个 “池子里”,方便后续随取随用。
这个池子就是线程池。
七、在Java代码中创建线程的方法
八、后台线程与前台线程[这两概念还是蛮重要的]
后台线程(守护线程):后台线程不影响进程结束。一个进程中的前台线程都结束了,后台线程还没执行完,也会跟着进程的结束而退出。
前台线程:前台线程会影响进程的结束。如果前台线程还没结束,进程是无法结束的。
一般默认我们创建的线程,默认是 前台线程,不过在代码中我们可以通过方法 setDaemon()修改前台线程成后台线程。
/**
 * 将一个 前台线程 设置成 后台线程
 */
public class testSetDaemon {
    public static void main(String[] args) {
        Thread t = new Thread(()->{
            while (true){
                System.out.println("hello world!");
            }
        });

//        将 前台线程 设置成 后台线程
        t.setDaemon(true);
        t.start();
    }
}
运行结果:

没进行设置之前,我们都能猜到预期结果:创建出的新线程在循环打印hello world。
但是当将其设置成后台线程后,进程唰的一下就结束了,这是为啥??
这是因为设置后只剩下了main为入口方法的主线程是一个前台线程,由于main并没有什么代码需要执行,因此该前台线程很快就执行完毕了,此时后台线程即便没执行完毕,他也无法影响到进程的结束,也要跟着进程结束而退出执行。