文章目录
一、大模型之旅
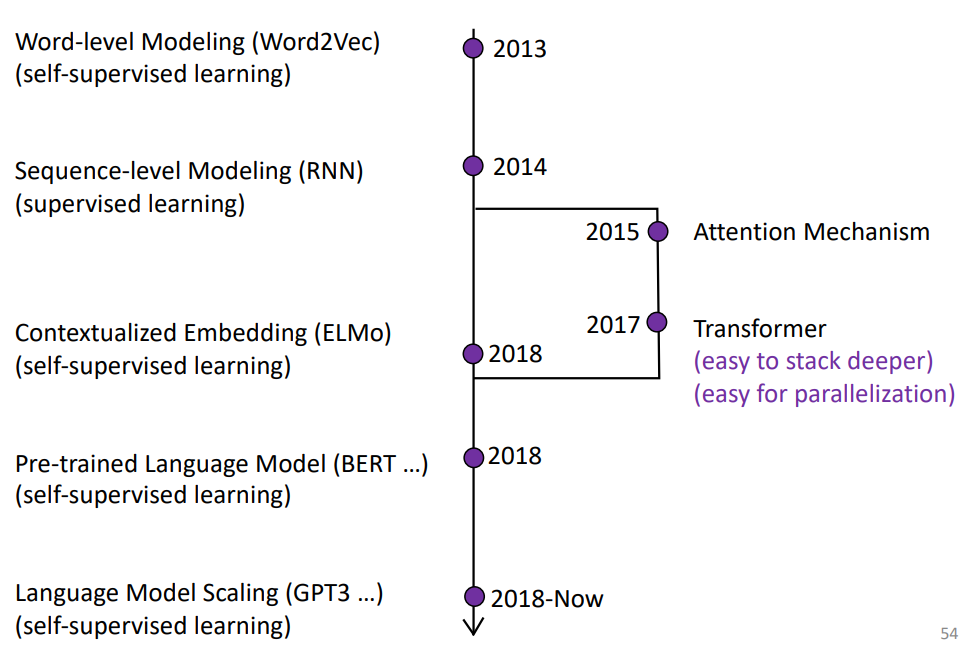
13 年之后,随着深度学习技术的发展,NLP发展也受到了很大的影响
13年,Word2Vec
14年,RNN
18年,ELMo
现在,大量去使用预训练语言模型
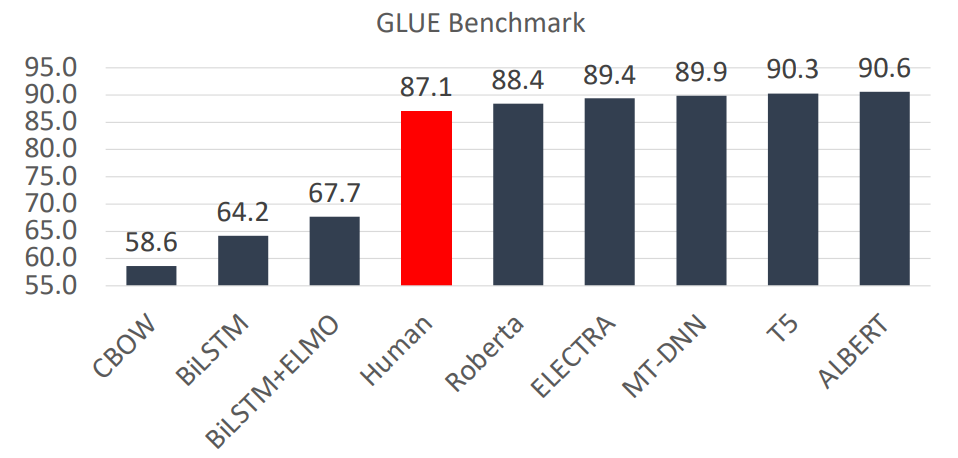
The General Language Understanding Evaluation (GLUE) benchmark is a collection of resources for training, evaluating, and analyzing natural language understanding systems.
之所以选择预训练语言模型,是因为之所以选择预训练语言模型在 GLUE 上的结果优于人类的表现,这反映了预训练语言模型的语言理解能力
预训练语言模型主要有三个特征:
-
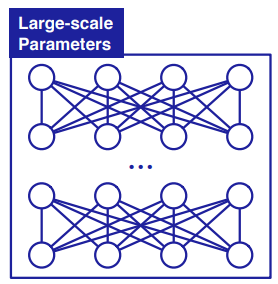
大量参数
-
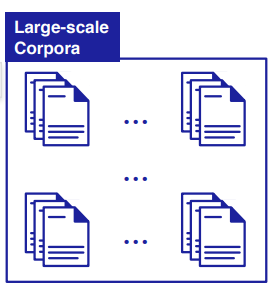
大量数据
-
大量计算
其中,增加参数和数据是进一步提高模型性能的有效手段。从GPT-3 (1750亿个参数) 中,我们可以看到大规模预训练语言模型中的丰富知识
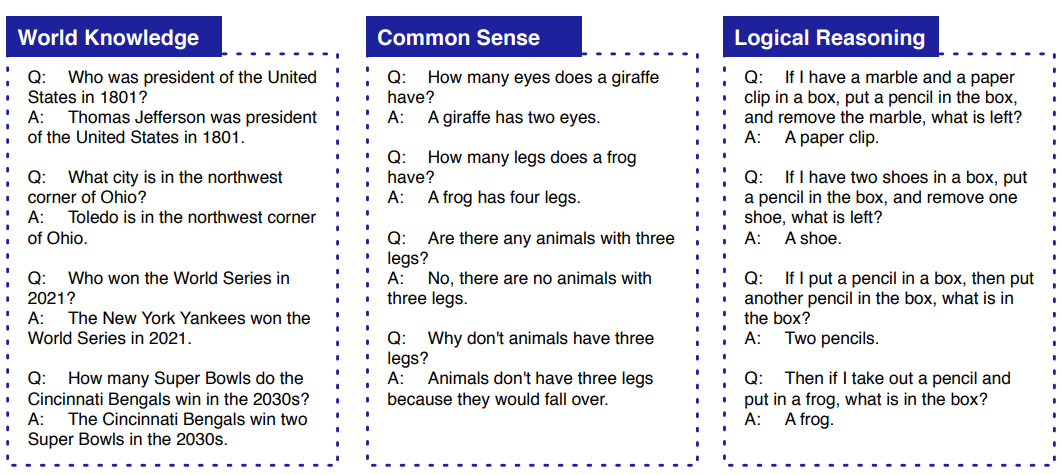
此外,GPT-3 在许多任务上具有强大的零/少镜头学习能力,例如少镜头机器翻译
在GPT-3中,许多复杂的任务,如编写代码和下棋,可以转化为基于预先训练的语言模型的动作序列生成
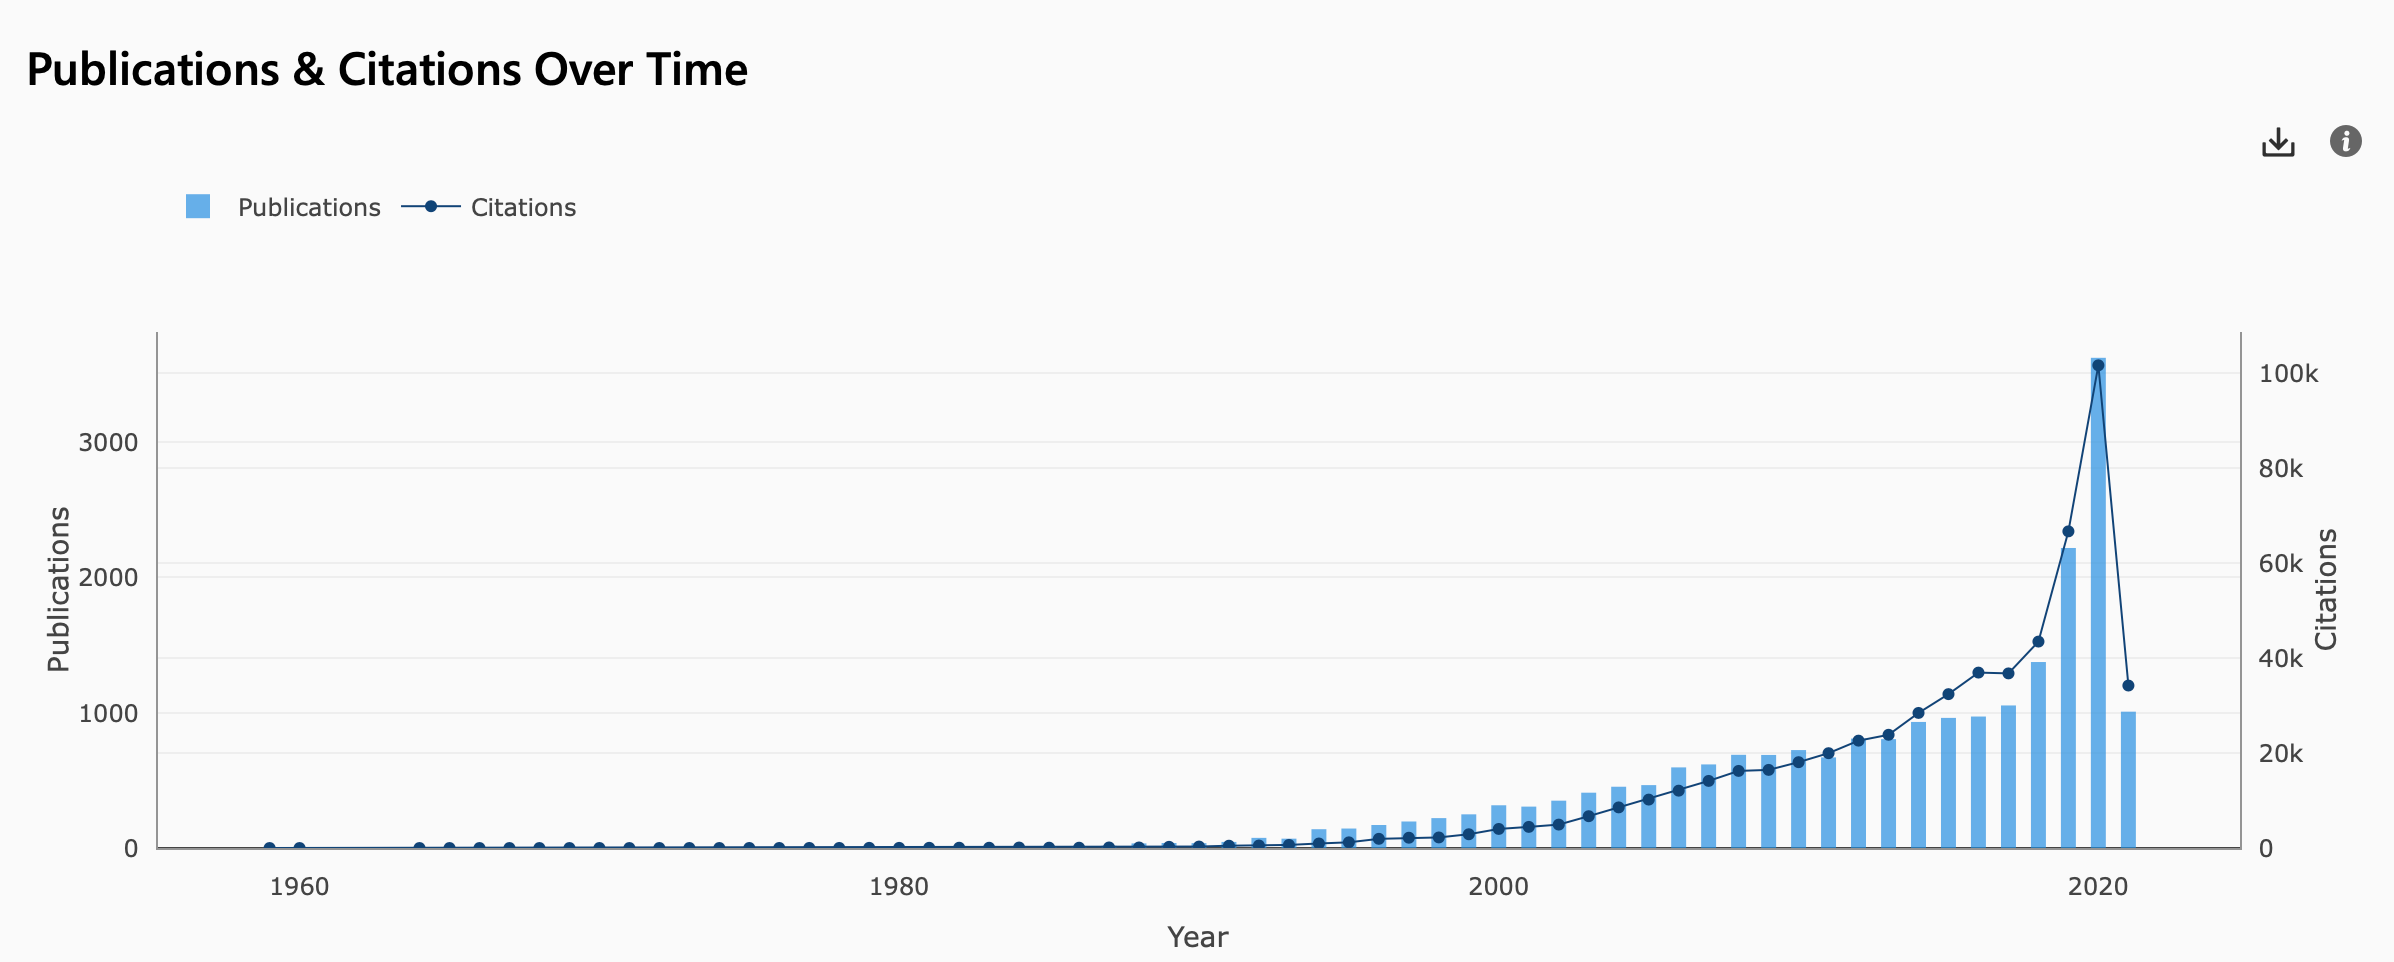
基于以上的特点,使用预训练的语言模型现在是各种 NLP 任务的标准,与语言模型相关的研究也在 2018 年迅速发展了起来。
二、大模型背后的范式
第一步:在预训练阶段,预训练语言模型从大规模未标记数据中提取知识
第二步:然后,我们可以使用特定任务的训练数据对预先训练的语言模型进行微调,以适应预先训练的知识
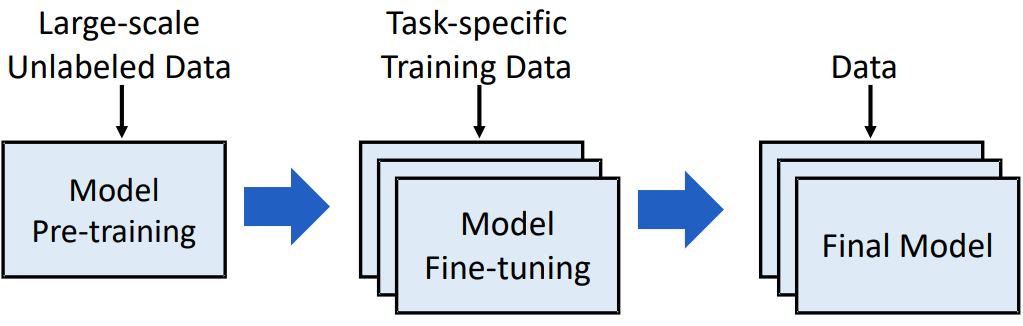
预训练和微调的基本范式可以追溯到迁移学习(transfer learning)。人类可以应用以前学到的知识来更快地处理新问题,我们希望机器具有类似的能力。迁移学习采用 “先培训后微调” 的框架,实现 “知识获取后知识转移”