目录
1、特点与应用场景
| awk | |
| 一门语言,类似于C语言 | |
| 过滤,统计,计算 | |
| 分析日志 |
2、awk命令执行流程
3、awk行与列
| 名词 | awk中叫法 | 一些说明 |
| 行 | 记录record | 每一行默认通过回车来分割 |
| 列 | 字段,域,filed | 每一行默认通过空格来分割 |
1)awk取行
| awk | |
| NR==1 | 取出某一行 |
| NR>=1 && NR<=5 | 取出1到5行范围 |
| / / | 过滤 |
| / / , / / | 替换 |
| > < >= <= == != | 符号 |
示例:


2)awk取列
| awk | |
| - F | 指定分隔符,指定每一列结束标记(默认是空格,tab键) |
| $ 数字 | 取出某一列 |
| $ 0 | 取出整行的内容 |
| print { XXX} | 与$数字搭配使用 |
| $NF | 取出最后一列 |
示例:


补充:column -t 命令使的格式对齐

使用awk调换passwd 第一列和最后一列内容,显示每一行内容(调换后的)

3)awk行与列综合使用
取出网卡IP地址

4、awk模式匹配-正则匹配
| 正则 | awk正则 |
| ^表示以....开头的行 |
某一列的开头 $数字~/^.../ |
| $表示以......结尾的行 | 某一列的结尾 $数字~/...$/ |
| ^$表示空行 | 某一列是空的 |


5、awk模式匹配-范围模式
| /哪里开始/,/哪里结束/ 常用 |
| NR==1,NR==5 从第1行开始到第5行结束,类似于sed -n '3,5p' |

6、awk模式匹配-特殊模式
| 模式 | 含义 | 应用场景 |
| BEGIN | 里面的内容会在awk读取文件之前执行 | 1)进行简单统计,计算,不设计读取文件 2)用来处理文件之前,添加个表头(不常用) |
| END | 里面的内容会在awk读取文件之后执行 | 1)awk进行统计,一般先进行计算,最后END里面输出结果 2)awk数组,用来输出数组结果(经常用) |

7、awk数组*
1)用途
| 统计日志 |
| 统计次数 |
| 统计每个IP出现次数 |
| 统计每种状态码出现次数 |
| 统计系统中每个用户被攻击的次数 |
| 统计统计攻击者IP出现次数 |
| 累计求和统计每个IP消耗的流量 |
2)格式对比
| Shell数组 | awk数组 | ||
| 形式 | array[0]=a array[1]=b |
array[0]=a array[1]=b |
|
| 使用 | echo ${array[0]} ${array[1]} |
print array[0] arry[1] |
|
| 批量输出数组内容 | for i in $(array[*]) do echo $i done |
for(i in array) print array[i] |
awk数组专用循环,变量获取到时数组的下标, 需要获取数组内容,格式为 数组名字[下标] |
示例:
将url.txt文件中的域名取出并根据域名进行计数处理

8、awk循环与判断


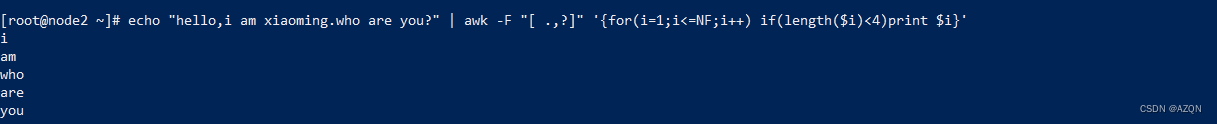
示例:
hello,i am xiaoming.who are you?
统计这段话中字符数小于4的单词,显示出来