一、写在前文:最小二乘法
早在19世纪,勒让德就认为让“误差的平方和最小”估计出来的模型是最接近真实情形的。为什么就是误差平方而不是其它的,这个问题连欧拉、拉普拉斯都未能成功回答,后来是高斯建立了一套误差分析理论,从而证明了确实是使误差平方和最小的情况下系统是最优的。
最小二乘法公式如下图所示:
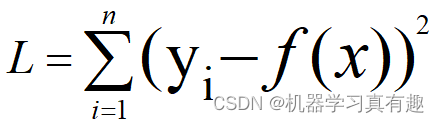
二、引出:损失函数
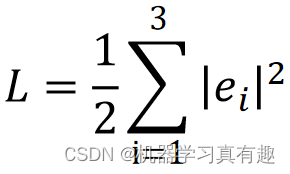
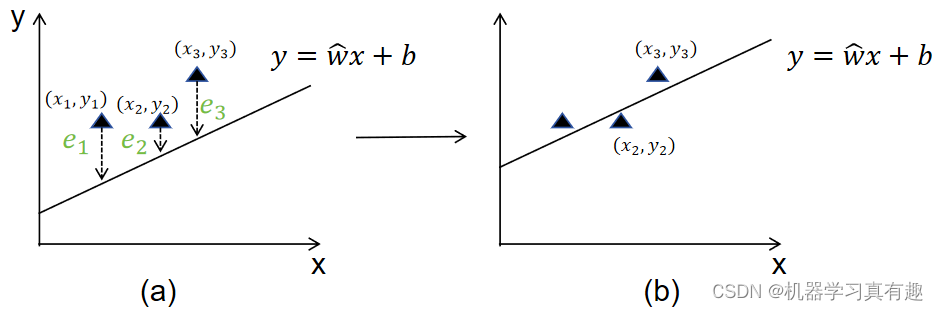
首先我们把图(a)中三个样本的距离误差写成一个最小二乘的方式:也称为损失函数(1/2是用来方便后续求导的,可理解为一个常数)
通过将三个样本数据带入公式,得到一个关于b的二次方程。
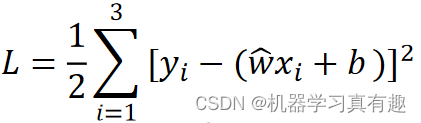
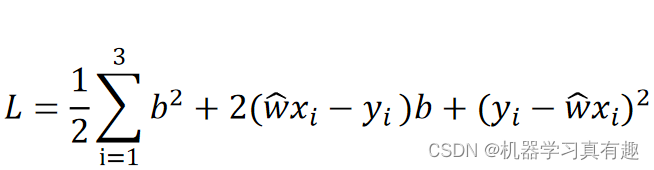
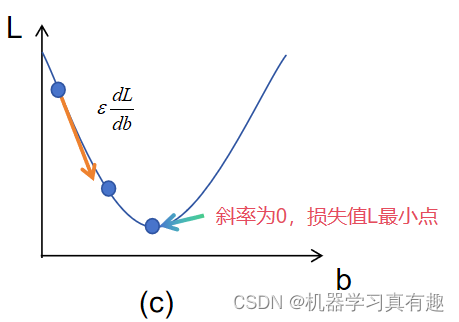
假设L与b的关系为图(c)所示,图中损失函数L最小的时候为最优值。最小二乘法的核心思想就是一个函数拟合的思想,此时y函数的状态由(a)转换到(b)。
三、进入主题:梯度下降算法
通过上述可知,我们可以找到让损失函数最小的b值,现在我们换一种求解思路。
假设随便给定一个b值,能够通过迭代优化的方式找到最好的b值?
如图(c)所示,可以求出当前值点的斜率,然后乘以一个常数(先不用对这个常数深究),然后通过 b=b-
*斜率 更新b值。更新后的b值代入L,损失函数会变得更小。可以根据新的b值调整拟合函数的位置。继续迭代,直到优化到斜率为0的点,b值不再更新,就找到最好的值,优化过程结束,这就是梯度下降算法。
四、扩展:以一般的形式再来理解这个梯度下降算法
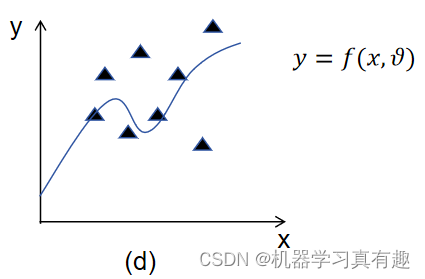
与前面不同的是:1.数据样本不只有三个 2.函数是任意一个非线性函数 3.优化的参数不再是b,而是
此时的第i个样本点的损失函数定义为:
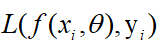
接下来 1.对求偏导 2.求均值 3.
沿着梯度负方向移动使损失函数变小。其中
也被我们成为学习率,人为控制,用来控制梯度下降的步长。
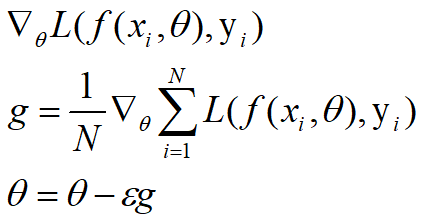
问题来了:如果每次都将所有样本计算在内,会造成内存开销问题,更新速度慢
解决办法:使用少部分数据进行参数更新,即使用少部分样本求均值。实现过程就是:每次随机从n个样本中选择m个样本,而且每次都不重复。这种方法称为随机梯度下降。当样本方差较小时,使用少部分样本,虽然会引入噪声,但是仍然可以按照正确的趋势收敛函数。
五、动量随机梯度下降
随机梯度下降有时会失效,例如,深度学习网络训练往往是一个非凸的优化过程,在参数空间里分布着各种山脊和山谷。
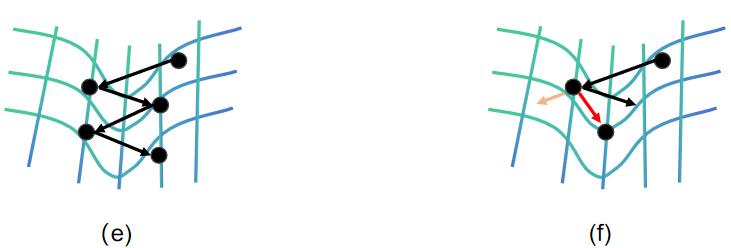
遇到问题:图e为梯度下降出现震荡现象,无法收敛到山谷。
解决办法:图f中展示了我们的解决办法,即在更新梯度的时候,不仅计算新的梯度,还有保留部分上一次的梯度。结合两个方向,构成新的更新方向。
使用数学语言来表述这个算法:动量随机梯度下降。
引入的动量用v表示,v=av-g,其中a用来控制历史动量对新方向的影响程度。
参数更新变成=
+v。
五、学习率
一般情况下,我们为了快速找到收敛方向,都会设置一个大一点的初始学习率,随着训练过程,我们需要找到一个最好的结果,不能再只追求收敛速度,需要细致优化防止损失函数剧烈震荡。
具体操作为:设置初始值,每隔一段时间降低学习率。这是一种比较粗犷的调整方式。
出现问题:神经网络研究人员意识到手动调整学习率非常困难。
尝试解决:可不可以根据梯度让他们自己调整。
引入新的变量:r
r=r+g^2,r就是梯度大小随着时间的积累量
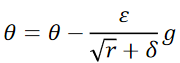 ,其中
是一个小量,用稳定数值计算,防止分母为0。
如上公式可得出,把根号r放在学习率的分母上,当梯度波动很大的时候,学习率将会快速下降。相反,波动小的时候,学习率就会小一点。,这样就实现了自动调整。
这个改进算法就是2011年提出的adagrad算法。
出现问题:这样r的变化只和梯度有关,可能让学习率过早的变小而不好控制。故而引出2012年的rms prop算法:
r=ρr+(1−ρ)g^2
出现想法:动量+学习率,引出2014年的adam算法。
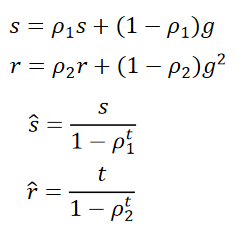 其中,s为自适应动量,r为自适应学习率。下面公式为s和r的修正公式。
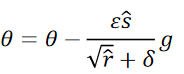
这就是adam算法思想。
总结:
1.梯度下降算法(Gradient Descent,GD),深度学习最核心的算法之一
*考虑到内存限制和迭代速度,我们每次只抽取部分样本优化。引出SGD算法->
2.随机梯度下降算法(Stochastic Gradient Descent,SGD)
*为了让算法在非凸优化问题中,更好的找到损失函数的最小值,引出动量概念->
3.动量(Moment)
*为了在训练过程中为了保证一个好的学习率,引出自适应学习率算法->
4.自适应学习AdaGrad和RMSProp算法
为了兼顾动量和自适应学习,引出集大成者Adam算法->
5.动量&自适应学习Adam