目录
介绍:
本文重点讲解C++11标准语法,由于C++11增加的语法特性篇幅非常多,这里没办法一一讲解,本文重点介绍C++11的初始化列表、声明、左右值引用和移动语义。
一,统一的列表初始化
1-1,初始化列表
这里所说的初始化列表不是构造函数中的初始化列表,而是大括号 “{}”,即用于初始化数据的大括号叫做初始化列表。
C++11标准之前,大括号{}只能对特定的场景进行初始化,如数组、结构体等,常用于多元素的初始值设定。C++11扩大了大括号{}初始化的使用范围,使其可用于所有的内置类型和用户自 定义的类型,使用初始化列表时,可添加等号(=),也可不添加。
#include <iostream>
using namespace std;
struct Point
{
int _x;
int _y;
};class Date
{
public:
Date(int year, int month, int day)
:_year(year) ,_month(month) ,_day(day)
{ }
private:
int _year;
int _month;
int _day;
};
int main()
{
//1,大括号可用于所有的内置类型和用户自定义类型的初始化
//2,使用大括号初始化可不加等号(=)
//自定义类型
int a = 0;
int b = { 1 };
int c{ 2 };
int arr[]{ 1,2,3 };//内置类型
Point p{ 1, 2 };
int* pa = new int[4]{ 0 };//调用构造函数初始化
Date d2{ 2022, 1, 2 };
Date d3 = { 2022, 1, 3 };
return 0;
}
C++11标准在这里强调的是一切皆可使用{}初始化,包括调用自定义类型的构造函数初始化。在初始化时也可不加等号(=)。
补:平常使用 “()” 初始化是专门调用构造函数初始化的,如:int a(1); int e = int(2)。这不是在C++11标准后才开始支持的语法,在C++有了模板之后就支持了构造和拷贝构造,即支持“()”。
1-2,initializer_list初始化容器
initializer_list其实并不是一个真正的容器,它可以理解为一种适配器,用于表示使用特定类型值的数组,常用于构造函数初始化对象。initializer_list提供了对初始化列表中元素的访问,就像访问数组一样,它用于表示对象的列表初始化,它使得程序员能够使用花括号{}来初始化对象。如:vector容器中,我们通常可直接vector<int> v = { 1,2,3,4 };一次性初始化任意数量的int型数据。它底层结构就使用了initializer_list才具有此功能。其它类似容器同理。这里我们以vector为例,运用initializer_list实现vector的构造函数如下:
示例1:
template<class T>
class vector {
public:
typedef T* iterator;/*像vector<int> v = { 1,2,3,4 };vector<char> v = { 'a','b','c' }等以数组的形式进行初始化将会调用以下构造函数*/
vector(initializer_list<T> l)
{
_start = new T[l.size()];
_finish = _start + l.size();
_capacity = _start + l.size();
iterator vit = _start;
typename initializer_list<T>::iterator lit = l.begin();
while (lit != l.end())
{
*vit++ = *lit++;
}
//for (auto e : l)
// *vit++ = e;
}
private:
iterator _start;
iterator _finish;
iterator _capacity;
};
示例2:
#include <iostream>
#include <initializer_list>
class A
{
public:
A(std::initializer_list<int> list) {
for (const auto& value : list) {
std::cout << value << ' ';
}
std::cout << std::endl;
}
};
int main()
{
A a{ 1,2,3,4,5 }; //使用 initializer_list 进行初始化
return 0;
}
下面我们来分析initializer_list占用的空间大小。
initializer_list内部维护了一个指向堆上的数组以及该数组的长度,但不拥有所指向数组的内存。它内部有一个成员函数size()——用于获取初始化列表中元素的数量,以及一个成员函数begin()和end()——用于获取指向初始化列表开始和结束位置的迭代器。因此,initializer_list本身并不占用除指针和长度之外的额外空间,它本身占用的空间相对较小,主要是指针和长度的开销。数组真正占用的存储空间是由其引用的初始化列表所占用的。
initializer_list所占用的空间主要取决于它引用的初始化列表的大小。这个列表通常是在创建initializer_list对象时传递的,并且存储在堆或其他适当的内存区域中。initializer_list仅保存指向这个列表的指针和列表的长度,以便在需要时可以访问和迭代这些元素。
#include <iostream>
#include <vector>
#include <initializer_list>
using namespace std;
int main()
{
auto il1 = { 1, 2, 3, 4, 5, 6, 7, 8, 9 };
initializer_list<int> il2 = { 1, 2, 3, 4, 5, 6, 7, 8, 9 };
cout << sizeof(il1) << endl; //输出8,没有存储初始化列表数据的空间
cout << sizeof(il2) << endl; //输出8,没有存储初始化列表数据的空间vector<int> v1 = { 1,2,3,4,5,6,7,8,9 }; //调用内部initializer_list
for (auto e : v1)
{
cout << e << " ";
}
cout << endl;v1 = { 10, 20,30,40,50 }; //调用内部initializer_list
for (auto e : v1)
{
cout << e << " ";
}
cout << endl;return 0;
}
二,类型声明
2-1,auto用法的修改
C++98及之前,auto只是一个存储类型的说明符,表示变量是局部自动存储类型,但是局部域中定义局部变量默认就是自动存储类型,所以auto就没什么价值了。C++11中废弃auto原来的用法,将其用于实现自动类型推断。这样要求必须进行显示初始化,让编译器将定义对象的类型设置为初始化值的类型。平常我们使用auto来接收类型时,编译器必须更新C++11标准。
2-2,decltype关键字
关键字auto用于接收类型,而关键字decltype的作用是将变量的类型声明为表达式指定的类型。
#include <iostream>
#include <vector>
using namespace std;
template<class T1, class T2>
void F(T1 t1, T2 t2)
{
decltype(t1 * t2) ret;
cout << typeid(ret).name() << endl;
}
int main()
{
const int a = 1;
const int* b = &a;
const int* const c = b;
cout << typeid(a).name() << endl; //输出int
cout << typeid(b).name() << endl; //输出int const *
cout << typeid(c).name() << endl; //输出int const *
cout << endl;const int x = 1;
double y = 2.2;
decltype(x * y) ret; //decltype声明ret类型,ret的类型是double
decltype(&x) p; //decltype声明p类型,p的类型是const int*
cout << typeid(ret).name() << endl; //输出double
cout << typeid(p).name() << endl; //输出int const *
F(1, 'a');//创建x类型的顺序表v
vector<decltype(x)> v;
return 0;
}
三,STL容器的变化
首先,C++11标准在STL中增添了部分容器,下面用橘色圈起来是C++11中的一些几个新容器,但是实际最有用的是容器unordered_map和unordered_set。其他的只需了解即可。

容器新增用法的缺陷:
C++11标准发布后,STL容器增添了不少新用法,这些用法有些意义重大,但有一说一,部分用法的加入可以说无关痛痒,意义不大,如提供了cbegin和cend方法返回const迭代器等等,begin和end也是可以返回const迭代器的,专门实现cbegin和cend方法完全没必要。
其次,对于C++11增添的用法,如果我们再细细去观察会发现基本每个容器中都增加了一些,但是其实很多都是用得比较少的,可以说C++的缺陷之一就是语法杂而不华,复杂而又不精华的语法和特性令人头疼。
容器新增用法的优点:
C++11为容器底层增添了initializer_list用法及一系列的构造,大大优化了容器的用法。其次,容器还新增右值引用的用法(如push、insert等)、移动构造和移动赋值,这提高了STL的效率,减少了拷贝。
四,右值引用和移动语义
4-1,左值引用和右值引用
首先我们先明白什么是左值,什么是右值。
左值:一个表示数据的表达式,通常指的是有持久存储期的对象,表示一个可以被修改的内存位置。比如变量、数组元素、结构体的成员、解引用的指针等。我们可以获取左值的地址且对它赋值,除此之外,它还可以出现赋值符号的左边或右边。平常我们操作最多的数据以及对象基本都是左值。
右值:它也是一个表示数据的表达式,通常指的是一个临时的、不可修改的值,表示一个临时的、不可修改的值。如:字面常量、表达式返回值,函数返回值(这个不能是左值引用返回)等等一系列临时对象(如表达式的结果)或者没有持久存储期的对象。右值可以出现在赋值符号的右边,但是不能出现出现在赋值符号的左边。右值通常也不能取其地址(但某些右值引用类型的变量可以)。
#include <iostream>
using namespace std;
/*返回右值。func1返回的是其静态局部变量x的一个临时拷贝。临时拷贝是一个临时的数值,属于右值*/
int func1()
{
static int x = 5;
return x;
}/*返回左值。func2的返回类型是int&,它是一个引用类型。func2返回的是对静态局部变量 x的一个引用,表示对象x,是一个具有持久存储周期的变量,属于左值*/
int& func2()
{
static int x = 5;
return x;
}
int main()
{
//左值。类似于以下具有持久存储期的对象
double x = 1.1, y = 2.2;
func2();//以下几个都是常见的右值
10; //字面常量
x + y; //表达式返回值
func1(); //函数返回值//编译报错:表达式必须是可修改的左值或函数指示符
//不能赋值
/*10 = 1;
x + y = 1;
func1() = 1;//不能取地址
&10;
&(x + y);
&func1();*/const int a = 7;
const int* p = &a; //a还是左值,仍可取地址
return 0;
}
下面我们来观看左值引用与右值引用。
左值引用就是对左值的引用,给左值取别名。我们平常使用单个 “&” 的引用叫做左值引用。右值引用就是对右值的引用,给右值取别名。右值引用的符号是 “&&”。右值本身不能取地址和进行赋值操作,但是给右值取别名后,会导致右值被存储到特定位置,这样就可以取到该位置的地址和修改其值,右值引用底层指针存储的就是这块空间的地址。
#include <iostream>
using namespace std;
int main()
{
int a = 4, b = 2;
int&& p = a + b;
cout << p << " "; //输出6
p = 7;
cout << p << endl; //输出7int&& pp = 10;
cout << pp << " "; //输出10
pp = 0;
cout << pp << endl; //输出0
return 0;
}
以上右值引用特性了解即可,实际中右值引用的使用场景并不在于此,这个特性也不重要。语法上,无论左值引用还是右值引用,都是给对象取别名,本身并不开辟空间,底层中都是用指针实现的。
4-2,左值引用与右值引用比较
一般情况下,左值引用只能引用左值,右值引用只能引用右值。但是const左值引用既可引用左值,也可引用右值,即常引用。右值引用要想引用左值必须使用move函数。
在C++中,move不是一个真正的函数,而是一个函数模板,它接受一个任意类型的左值引用,并将其“转换”为右值引用。但是,重要的是要理解move并不实际移动任何数据,它只是进行了类型的转换,即所谓的“强制转换”为右值引用。
#include <iostream>
using namespace std;
//返回右值
int func1()
{
static int x = 5;
return x;
}//返回左值
int& func2()
{
static int x = 5;
return x;
}int main()
{
double x = 1.1, y = 2.2;//右值引用
int&& rr1 = 10; //错误使用: int& rr1 = 10;
double&& rr2 = x + y; //错误使用: double& rr2 = x + y;
double&& rr3 = func1(); //错误使用: double& rr3 = func1();//右值引用取地址操作
int* p = &rr1;//左值引用引用右值
const int& r1 = 10;
const double& r2 = x + y;
const double& r3 = func1();//move处理左值,右值引用引用左值
double&& pp1 = move(x);
double&& pp2 = move(y);
return 0;
}
4-3,左值引用和右值引用的使用场景
无论是左值引用还是右值引用都是引用,包含了引用的大多数优势。左值引用与右值引用主要针对于大型数据结构的返回和传递情况。对于大型数据结构,如果直接传递或返回,可能会导致大量的内存复制操作,从而降低程序的性能。通过使用引用,可以避免这种复制,提高程序的运行效率。 由于左值引用即可接收左值也可接收右值,所以左值引用能够解决所有的传递拷贝情况,但返回值拷贝的情况不能全部解决,如函数返回局部对象,一旦出了作用域就不存在了,不能使用左值引用返回。右值引用的增入主要解决此种问题。
下面我们来观察在没有右值引用前返回局部对象的情况。
平常我们使用多参构造时,实际上其实进行了两次构造。首先从多参数构造成对象类型,然后从对象类型进行拷贝构造。有些编译器会对此进行优化,直接转成构造或拷贝构造
#include <iostream>
#include <string>
using namespace std;
class Date
{
public:
Date(int year, int month, int day)
:_year(year)
, _month(month)
, _day(day)
{
cout << "Date(int year, int month, int day)" << endl;
}
private:
int _year;
int _month;
int _day;
};
int main()
{
//构造 + 拷贝构造 -> 优化,直接构造
Date d2 = { 2024, 3, 23 }; //多参数的隐式类型转换//构造 + 拷贝构造 -> 优化,直接构造
string s2 = "1111"; //多参数的隐式类型转换//C++98标准支持 "()" 的语法,运用构造函数
Date d1(2024, 3, 23);
string s1("1111");//引用临时变量,以下将无法进行优化
const string& s = "123";
return 0;
}
函数返回局部对象数据结构时同理,先进行拷贝构造生成临时变量,然后又通过此临时变量拷贝构造给接收对象,若是优化的编译器这里会直接进行一次拷贝构造给接收对象,但即便是这样,仍没有解决值拷贝的效率问题。
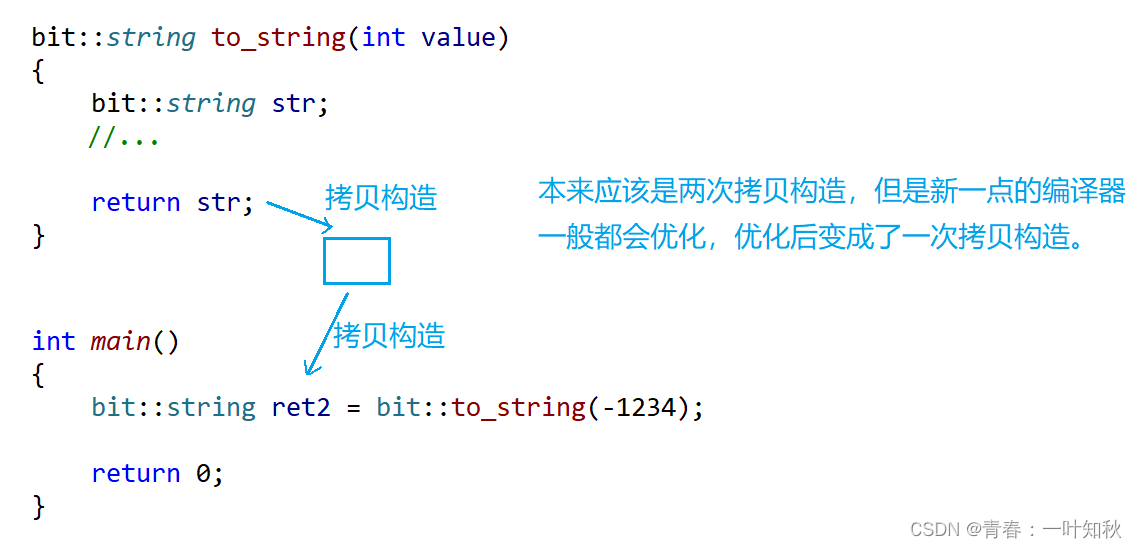
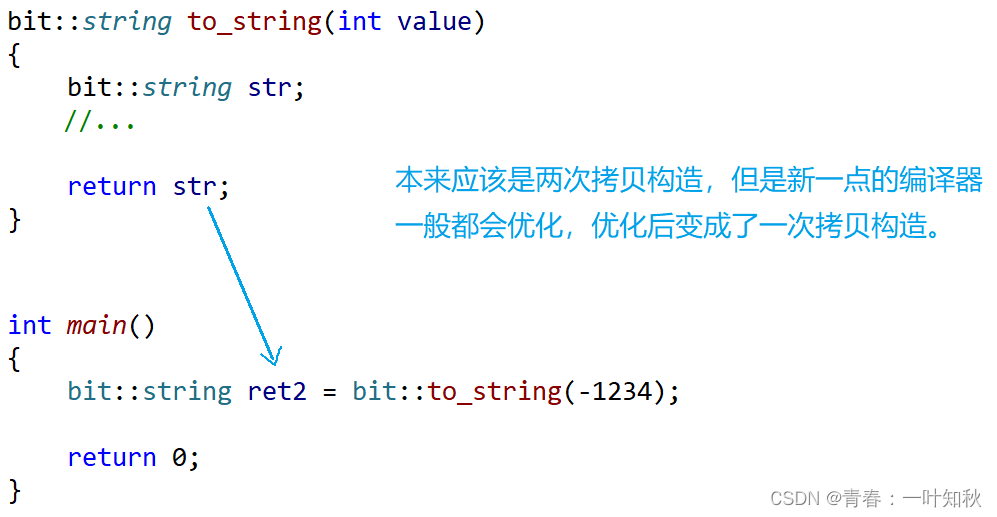
由于返回值是临时对象,这里无法使用引用返回(即左引用和右引用),但是返回大型数据结构时通常涉及到构造函数、拷贝构造函数或赋值运算符的调用。左引用实现这些方法时都是深拷贝实现,这样一来跟传统的按值返回函数构造临时对象(即返回值的拷贝)一样,而临时对象的生命即将结束,深拷贝下来可能会非常昂贵,尤其是当对象包含大量数据或资源(如动态分配的内存)时,至少要进行一次构造,如上图般。
右值引用解决这块问题时依靠的是移动语义。右值引用和移动语义允许我们“窃取”临时对象的资源,而不是复制它们。这通过“移动构造函数”和“移动赋值操作符”实现,这些特殊移动语义函数允许对象将其资源(如内存、文件句柄等)转移给另一个对象,进行的只是资源的移动,而不是复制它们。若便编译器没有优化,这里也只是进行了一次拷贝——拷贝临时对象,一次移动——资源移动给指定对象,没有像左值引用那般进行多次值拷贝,即避免了多次深拷贝;若编译器优化后,直接变成了一次移动,没有了临时对象的拷贝,与上图类似。
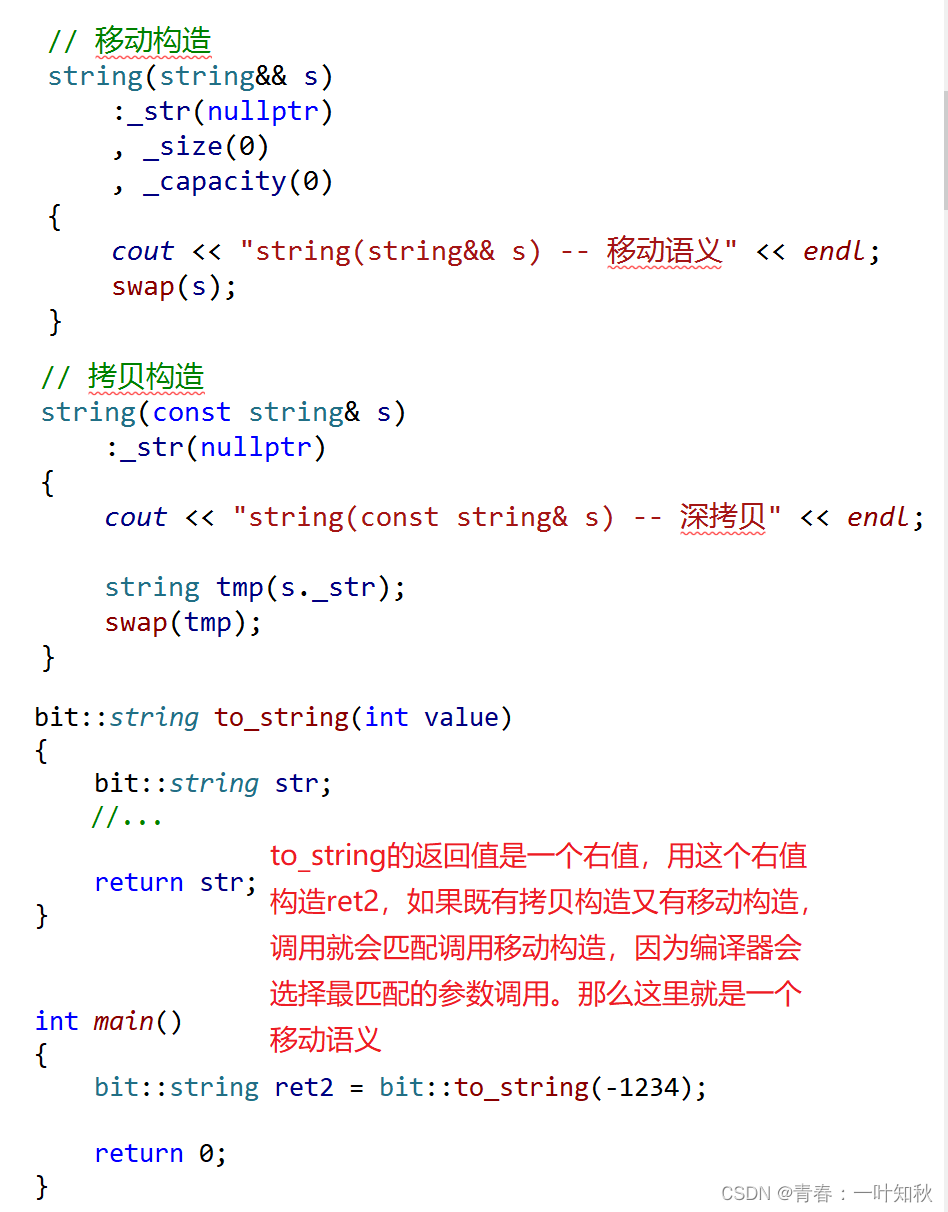
移动赋值同理,如下:
//移动赋值
string& operator=(string&& s)
{
cout << "string& operator=(string&& s) -- 移动语义" << endl;
swap(s); //资源的移动
return *this;
}
int main()
{
bit::string ret1;
ret1 = bit::to_string(1234); //移动语义的调用
return 0;
}
场景二:
#include <iostream>
#include <utility>
using namespace std;
class A
{
public:
//移动构造
A(int&& data) :_data(data)
{
cout << "A(int&& data)—移动构造" << endl;
}
A(A&& _A)
{
cout << "A(A&& _A)—移动拷贝" << endl;
swap(_A);
}
//拷贝构造
A(const int& data = 0) :_data(data)
{
cout << "A(const int& data = 0)—拷贝构造" << endl;
}
A(const A& _A)
{
_data = _A._data;
cout << "A(A& _A)—深拷贝" << endl;
}
//移动赋值
A& operator=(A&& _A)
{
cout << "A& operator=(A&& _A)—移动赋值" << endl;
swap(_A);
return *this;
}
//深拷贝
A& operator=(const A& _A)
{
cout << "A& operator=(const A& _A)—深拷贝赋值" << endl;
A a(_A);
swap(a);
return *this;
}
void swap(A _A) //注意: 使用void swap(A _A)交换这里会存在拷贝构造,即深拷贝
{
std::swap(_A._data, _data);
}
int _data;
};
A func1()
{
A a = 10;
return a;
}
int func2()
{
int a = 1;
return a;
}
int main() {
//调用函数,这里不会发生值拷贝,而是使用移动语义
A _c = func1();
cout << endl;
A _d = func2();
cout << endl;
_d = _c;
return 0;
}
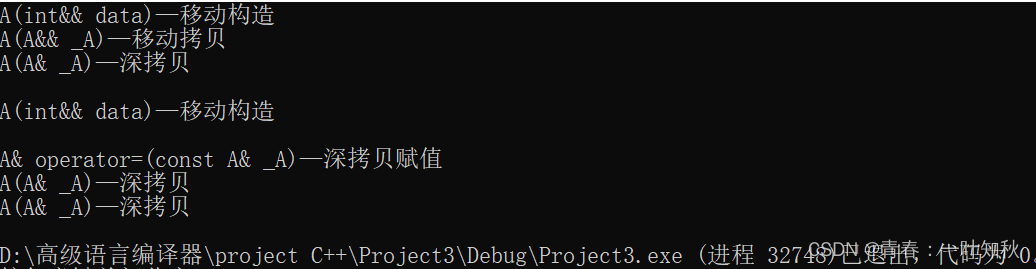
左值使用move函数后,它的返回属性(即表达式)就从左值变成了右值,但它本身还是左值,也就是说左值也可按照个人意愿调用移动语义,但是此用法一定要慎重,因为右值引用的本质是将右值即将结束生命里的资源全部转移的另一个对象中,右值对象即将“死亡”,我们可随意动用它的资源。左值引用由于左值生命周期还很长,不能轻易移动它的资源,一点移动它的资源,后面再次运用时就会出问题,因为move本身并不执行任何移动操作;它只是产生一个右值引用。实际的移动操作(即资源的窃取)是由移动构造函数或移动赋值运算符来执行的。这点在使用时需注意。
#include <iostream>
#include <string>
using namespace std;
int main()
{
string s1("abc");// 这里s1是左值,调用的是拷贝构造
cout << s1 << endl;//输出abc
/*这里我们把s1 move处理以后,会被当成右值,调用库中的移动构造,s1的全部资源转移给了s3,s1被置空了*/
string s2(move(s1)); //s1还是左值,调用拷贝构造
cout << s1 << endl;//资源被转移,输出空
return 0;
}
通过以上的运用可总结一点,浅拷贝的类不需要移动构造,因为一般情况下浅拷贝的对象消耗不是很大,如int型、指针型等,深拷贝的类要观看是否需要使用移动构造来转移资源,提高效率。
C++11之前,编译器在这方面做了不少努力,在很多场景下直接进行优化成一次拷贝,但效率上还是没有得到完全的解决。C++11增加了右值引用,使用了移动语义,配合编译器的优化,将这块深拷贝的问题完全解决。STL的容器增加了移动语义(即移动构造和移动赋值),处理大型数据结构的拷贝问题。
4-4,右值引用的深入
首先来说明右值引用的属性。右值被右值引用后,右值引用的属性其实是左值。右值引用的作用在于移动语义,移动语义的作用在于资源的转移,避免大型结构的深拷贝。若右值引用属性还是右值,那么右值根本无法被改变,资源也就无法被转移。
其次,左值加上const后属性还是左值,这一点不要被const的作用迷惑。const关键字只是限制对象本身不能被修改,并没有修改对象的属性,我们仍可对其操作和取地址。
最后,右值引用并没有延长右值的生命周期,也没有开辟空间,可以理解为延长了资源的周期,只是为了实现右值资源的移动。
#include <iostream>
using namespace std;
int main()
{
const int a = 7;
const int* p = &a; //a还是左值,仍可取地址int&& pp = 10;
pp++; //可以对右值引用进行操作,属于左值
return 0;
}
4-5,完美转发
C++11引入右值引用后,模板中的引用运用出现了两种情况,即左值引用传入和右值引用传入。如下:
template <typename T>
class Func
{
public:
void func(T& t); //左值引用或const左值引用
void func(T&& t); //右值引用或const右值引用/*注意,这里一般不会有const右值引用。通常const型右值引用通常没有实际意义,因为右值引用的主要目的是允许移动语义,而const会阻止这种移动,现实中根本不会出现,这里了解即可*/
}
这样一来显然比较麻烦。C++11直接使用万能引用包含了所有情况,符号“&&”。当调用万能引用时,它会根据传入的参数属性进行实例化出特定的属性。如下:
template <typename T>
//万能引用T&&直接包含了左值和右值的所有情况。
void func(T&& t); //万能引用。传入参数时,它会根据参数的属性实例化出四个版本之一:左值引用、右值引用、const左值引用、const右值引用
模板中的&&不代表右值引用,而是万能引用,其既能接收左值或const左值,又能接收右值或const右值。当传入左值时,万能引用&&解析为左值引用;当传入右值时,万能引用&&解析为右值引用;当传入const左值时,万能引用&&解析为const左值引用;当传入const右值时,万能引用&&解析为const右值引用。下面来对比以下几个模板版本。
#include <iostream>
#include <string>
using namespace std;
/*三个版本,之所以不实现T&版本是因为一旦传入左值时,T&版本比万能引用更合适,系统会优先选择T&版本*/
template <typename T>
void func(T&& a)
{
cout << "void func(T&& a)" << endl;
}
template <typename T>
/*此版本一般不做特殊处理(如:const int a;move(a);)不会传入,因为其它三种版本都比此版本合适,且现实中也基本不会运用const右值引用*/
void func(const T&& a)
{
cout << "void func(const T&& a)" << endl;
}
template <typename T>
/*const型都传入此版本中。万能引用也可引用const,但是此版本更为合适const型,系统会优先选择*/
void func(const T& a)
{
cout << "void func(const T& a)" << endl;
}int main()
{
//以下三个都输出void func(T&& a)
func(10); //右值
int a = 10;
func(a); //左值
string b = "bit";
func(b); //左值//以下三个都输出void func(const T& a)
const int _a = 0;
func(_a); //const型
const string _b = "bit";
func(_b); //const型
func("123"); //常量字符串,属于const char*,即const型
return 0;
}
这里我们发现万能引用与右值引用符号一样(“&&”),运用时可能区分不出哪个是万能引用哪个是右值引用。其实,它们两者之间是有显著的区别。
万能引用“&&”:参数类型必须是模板参数,且是模板函数。
右值引用“&&”:直接绑定到右值,没有模板参数参与。
//样例一:
void f(int&& data); //没有模板参数,属于右值引用
//样例二:
template<typename T>
void f(vector<T>&& param); //参数类型是vector<T>,不是T,属于vector<T>的右值引用//样例三:
template<typename T>
class vector{
public:
void push_back(T&& x); //不是模板函数,属于右值引用
}//样例四:
template<typename T>
void f(T&& data); //模板函数,参数类型是模板参数,属于万能引用
平常运用中出现情况最多的也就以上几种,这里可对比万能引用与右值引用的条件。
万能引用固然很方便使用,但是万能引用却存在更改对象属性的问题。具体形式如下:
#include <iostream>
using namespace std;
//Fun的四个版本
void Fun(int& x) { cout << "左值引用" << endl; }
void Fun(const int& x) { cout << "const 左值引用" << endl; }
void Fun(int&& x) { cout << "右值引用" << endl; }
void Fun(const int&& x) { cout << "const 右值引用" << endl; }
//万能引用
template <typename T>
void func(T&& a)
{
Fun(a); //a的属性全部是左值,使用move(a)后属性全部是右值
}
int main()
{
func(10); //右值
int a = 0;
func(a); //左值
func(move(a)); //右值
const int b = 8;
func(b); //const 左值
func(move(b)); //const 右值
return 0;
}
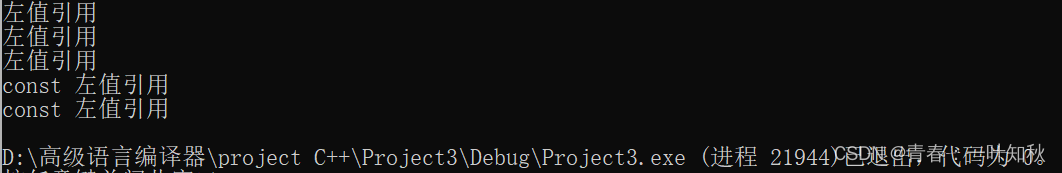
若是使用Fun(move(a)),将会输出以下:
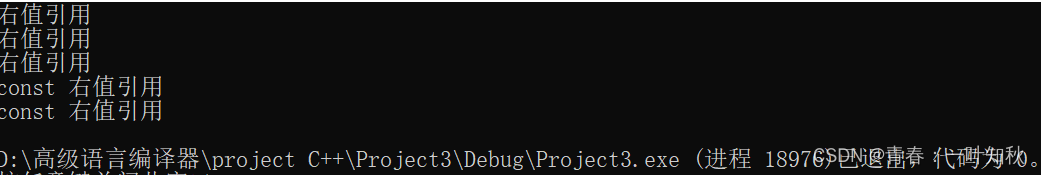
模板的万能引用只是提供了能够接收同时接收左值引用和右值引用的能力,但归根到底还是引用。无论是左值引用还是右值引用,它们的属性都是左值,后续的使用中都变成了左值运用,导致原本对象的属性改变。
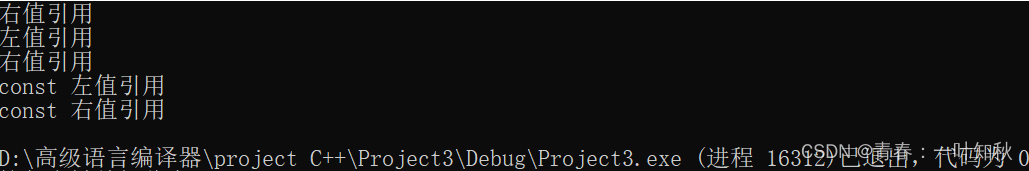
C++11加入了forward来解决这种问题。forward保持了原本属性。若属性是左值,这里不做任何变化;若属性是右值,这里相当于move了一下。
//forward的使用,代码如上,这里只将Fun参数使用forward版本
Fun(forward<T>(a));
改变后运行结果如下:
总: C++是一门极度追求效率的语言,所以在某些方面增添了许多语法(如右值引用),但在某些方面的增添确实不太实用(如初始化列表“{}”),这将导致语法复杂多样,因此很多人对这么语言都有褒贬看法。